반응형

전체 글 126

[떠먹여주는 논문리뷰] LeJEPA: Provable and Scalable Self-Supervised Learning Without the Heuristics

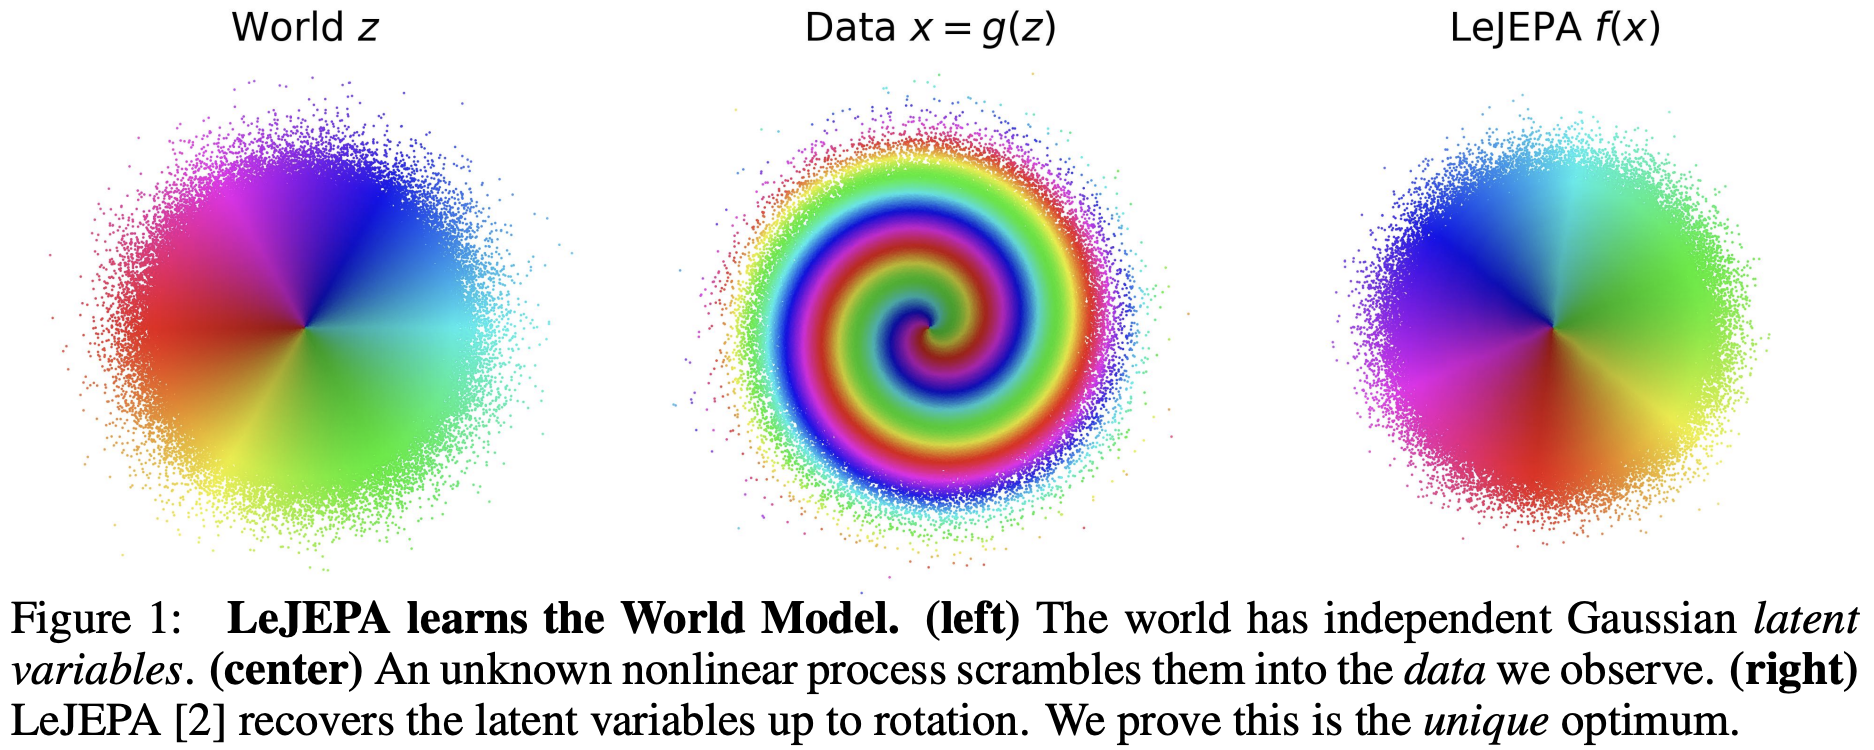
arXiv · 2025.11https://arxiv.org/pdf/2511.08544v3https://github.com/rbalestr-lab/lejepaAbstract세계와 그 dynamics를 조작 가능한 representation으로 학습하는 것은 AI의 핵심임.Joint-Embedding Predictive Architectures(JEPAs)는 유망한 설계도이지만, 실용적 지침과 이론이 부족하여 ad-hoc R&D에 의존하게 되었음.JEPA에 대한 포괄적인 이론을 제시하고, 이를 간결하고 확장 가능하며 이론적 근거가 있는 학습 objective인 LeJEPA로 구체화함.첫째, downstream prediction risk를 최소화하기 위해 JEPA embedding이 따라야 하는 최적 분포가..
AI/논문 리뷰 2026.10.30

[떠먹여주는 논문리뷰] LeWorldModel: Stable End-to-End Joint-Embedding Predictive Architecture from Pixels

arXiv · 2026.03https://arxiv.org/pdf/2603.19312v3https://github.com/lucas-maes/le-wmAbstract• Joint Embedding Predictive Architectures(JEPAs)는 compact latent space에서 world model을 학습하는 유망한 framework이지만, 기존 방법은 representation collapse를 피하려고 복잡한 다항 loss, exponential moving average, pretrained encoder 또는 auxiliary supervision에 의존해 여전히 취약함.• 본 연구는 next-embedding prediction loss와 latent embedding이 Gau..

AI/논문 리뷰 2026.10.28

[떠먹여주는 논문리뷰] H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning (arXiv 2026)

arXiv · 2026.10https://arxiv.org/pdf/2610.06805v1https://github.com/kevinghst/H-JEPAAbstractlatent world model로 long-horizon planning을 수행하려면 서로 다른 timescale과 abstraction level에 걸쳐 추론해야 함.기존 task-agnostic JEPA world model은 하나의 latent space에서, 흔히 단일 timescale로 예측하고 planning함.각 level이 자신이 학습한 latent space에서 더 먼 미래를 예측하는 action-conditioned JEPA hierarchy를 end-to-end로 학습하는 방법인 H-JEPA를 제안함.Planning은 t..

AI/논문 리뷰 2026.10.28

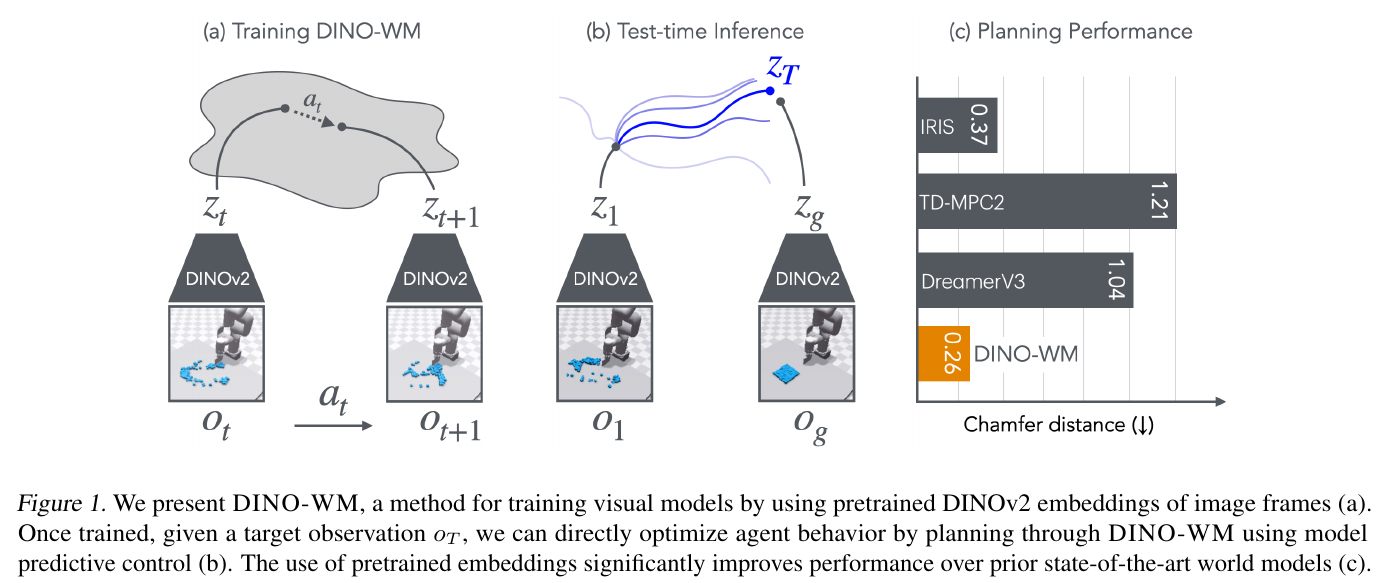
[떠먹여주는 논문리뷰] DINO-WM: World Models on Pre-trained Visual Features enable Zero-shot Planning

arXiv · 2024.11https://arxiv.org/pdf/2411.04983v2https://github.com/gaoyuezhou/dino_wmAbstractControl action이 주어졌을 때 미래 결과를 예측하는 능력은 physical reasoning의 기초임.그러나 흔히 world model이라 부르는 이러한 predictive model을 학습하는 일은 여전히 어려우며, 보통 online policy learning을 이용하는 task-specific solution을 위해 개발됨.World model의 잠재력을 충분히 활용하려면 1) 미리 수집한 offline trajectory로 학습 가능하고, 2) test-time behavior optimization을 지원하며, 3) t..

AI/논문 리뷰 2026.10.28

[Dataset] RECON dataset이란? world model에서 사용

RECON은 어떤 데이터인가원 논문은 Rapid Exploration for Open-World Navigation with Latent Goal Models (Shah et al., CoRL 2021, Berkeley AI Research). 제목 앞부분을 딴 이름이 RECON임플랫폼은 Clearpath Jackal UGV 한 대규모는 서로 다른 실외 환경 9곳, trajectory 5,000개 이상, 약 40시간 분량센서는 전방 스테레오 RGB 카메라, thermal 카메라, 2D LiDAR, GPS, IMU. world model 학습에 실제로 쓰는 건 대부분 RGB 프레임과 pose임사람이 조작한 시범 주행이 아니라, 로봇이 스스로 목표를 잡고 돌아다닌 self-supervised 수집 데이터임그..

AI/Dataset 2026.09.30

[논문리뷰] When Does LeJEPA Learn a World Model?

https://arxiv.org/pdf/2605.26379 들어가기 앞서 이 논문은..JEPA/LeJEPA류 self-supervised representation이 latent world structure를 linearly recover할 수 있는 조건을 증명한 이론 논문 1. 한 줄 요약 세계의 실제 latent variable이 독립 Gaussian이고, positive pair가 stationary additive-noise transition으로 생성된다면, LeJEPA의 alignment loss + Gaussian regularization은 관측 이미지 뒤에 숨어 있는 진짜 latent variable을 rotation까지만 애매하게 남기고 선형적으로 복원한다. 하지만 이 보장은 Gau..

AI/논문 리뷰 2026.06.12

[Dataset] ObjectNet download / ImageNet-V2 dataset download / 무엇인가

ObjectNet / ImageNet-V2 정리1. 왜 보는가ImageNet validation 성능만으로는 모델의 실제 일반화 성능을 충분히 보기 어려움.그래서 보통 ImageNet 계열 OOD 평가셋으로 함께 확인함.그중 대표적으로 많이 쓰는 것이 ImageNet-V2와 ObjectNet임.ImageNet-V2는 원래 ImageNet과 같은 1,000개 클래스를 유지하면서 새로 수집한 테스트셋이고,ObjectNet은 배경, 회전, 촬영 시점 편향을 줄여서 모델의 강건성을 더 엄격하게 보는 테스트셋임. (GitHub)2. ImageNet-V2가 무엇인가ImageNet-V2는 ImageNet benchmark를 다시 점검하기 위해 새로 만든 테스트셋임.원래 ImageNet과 같은 클래스 체계를 따르되, ..

AI/Dataset 2026.04.17

[Dataset] ImageNet-A, ImageNet-R, ImageNet-C download 다운받는법 / DINO eval 방법, 구성

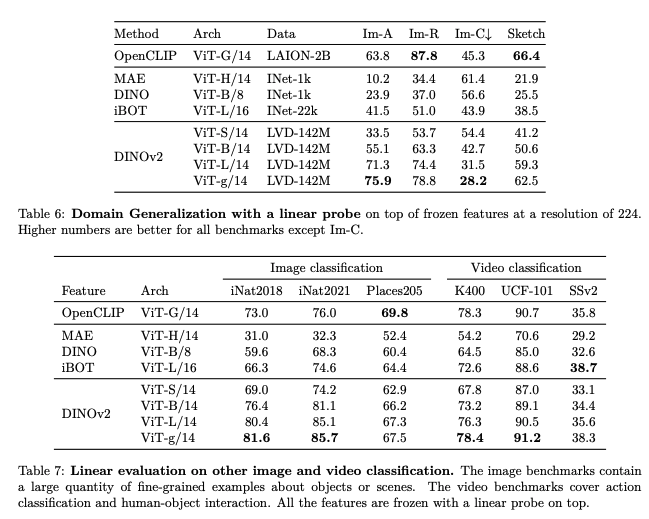
ImageNet-A “natural adversarial examples”용 벤치마크임. 합성 노이즈를 넣은 데이터가 아니라, 현실에서 자연스럽게 찍힌 원본 이미지인데도 기존 ImageNet 분류기가 자주 틀리도록 adversarial filtration으로 선별한 데이터임. 논문 기준으로 7,500장, 그리고 ImageNet-1k 중 200개 클래스 subset으로 구성됨. 그래서 이 벤치마크는 “모델이 진짜 object semantics를 봤는지, 아니면 ImageNet식 편한 cue에 너무 의존했는지”를 보기 좋음. 인간에게는 비교적 쉬운데 모델은 크게 무너질 수 있다는 점이 핵심임.ImageNet-R R은 rendition임. 즉 사진이 아니라 cartoon, painting, sketch, em..

AI/Dataset 2026.04.10

[Dataset] PASCAL VOC Segmentation dataset download 하는법

Pascal VOC 2012는 이미지 분할(Semantic Segmentation) 연구에서 가장 오래되고 널리 사용되는 벤치마크 중 하나이다.특히 모델의 기본적인 성능을 빠르게 확인하거나, 새로운 방법을 검증하는 초기 실험에 적합하다.1. 데이터셋 개요Pascal VOC 2012는 자연 이미지로 구성된 데이터셋이며,각 이미지에 대해 객체의 위치와 클래스 정보가 픽셀 단위로 주어진다.총 클래스 수: 21개 (배경 포함)객체 클래스: 20개배경 클래스: 1개2. 클래스 구성주요 클래스는 다음과 같다.사람: person동물: dog, cat, horse, cow, sheep탈것: car, bus, bicycle, motorbike, train, aeroplane실내/사물: chair, sofa, table,..

AI/Dataset 2026.04.10

[논문리뷰] From Culture to Clothing: Discovering the World Events Behind A Century of Fashion Images (ICCV 2021)

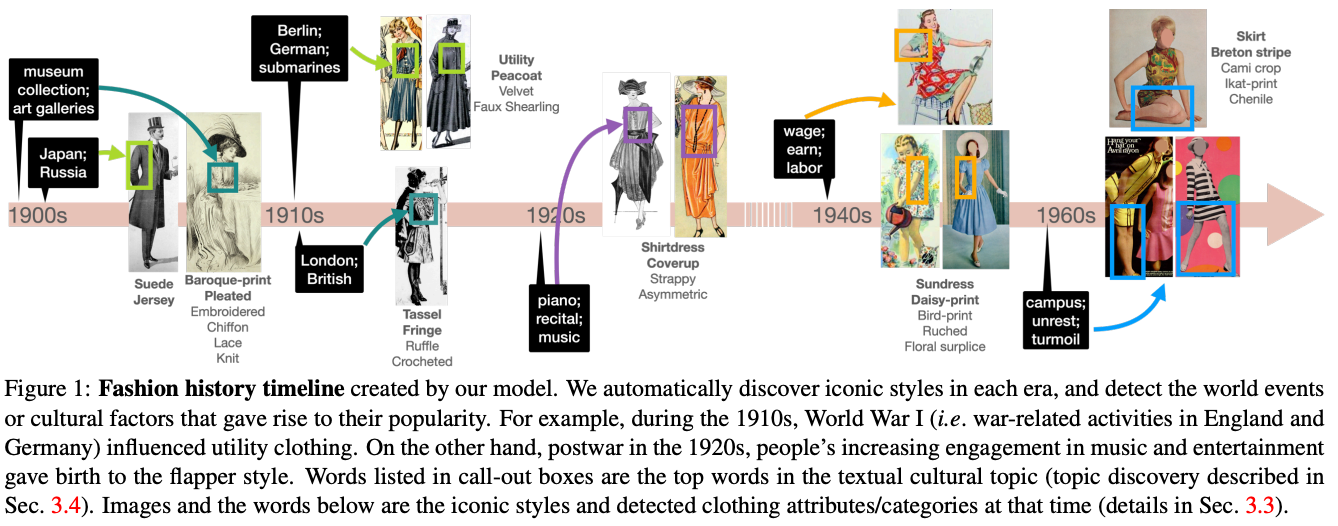
https://arxiv.org/abs/2102.01690 From Culture to Clothing: Discovering the World Events Behind A Century of Fashion ImagesFashion is intertwined with external cultural factors, but identifying these links remains a manual process limited to only the most salient phenomena. We propose a data-driven approach to identify specific cultural factors affecting the clothes people weaarxiv.org# fashion, ..

카테고리 없음 2026.04.07
반응형