arXiv · 2026.03

Abstract
• Joint Embedding Predictive Architectures(JEPAs)는 compact latent space에서 world model을 학습하는 유망한 framework이지만, 기존 방법은 representation collapse를 피하려고 복잡한 다항 loss, exponential moving average, pretrained encoder 또는 auxiliary supervision에 의존해 여전히 취약함.
• 본 연구는 next-embedding prediction loss와 latent embedding이 Gaussian distribution을 따르게 하는 regularizer라는 두 loss만으로 raw pixel에서 안정적으로 end-to-end 학습하는 최초의 JEPA, LeWorldModel(LeWM)을 제안함.
• 유일한 기존 end-to-end 대안과 비교해 조절할 loss hyperparameter를 6개에서 1개로 줄임.
• 약 15M parameter를 single GPU에서 수 시간에 학습하며, 다양한 2D/3D control task에서 경쟁력 있는 성능을 유지하면서 foundation-model 기반 world model보다 planning이 최대 48배 빠름.
• Physical quantity probing을 통해 LeWM의 latent space가 의미 있는 physical structure를 encode함을 보임.
• Surprise 평가에서도 물리적으로 불가능한 사건을 안정적으로 검출함을 확인함.
• 코드는 공식 GitHub에 공개함.
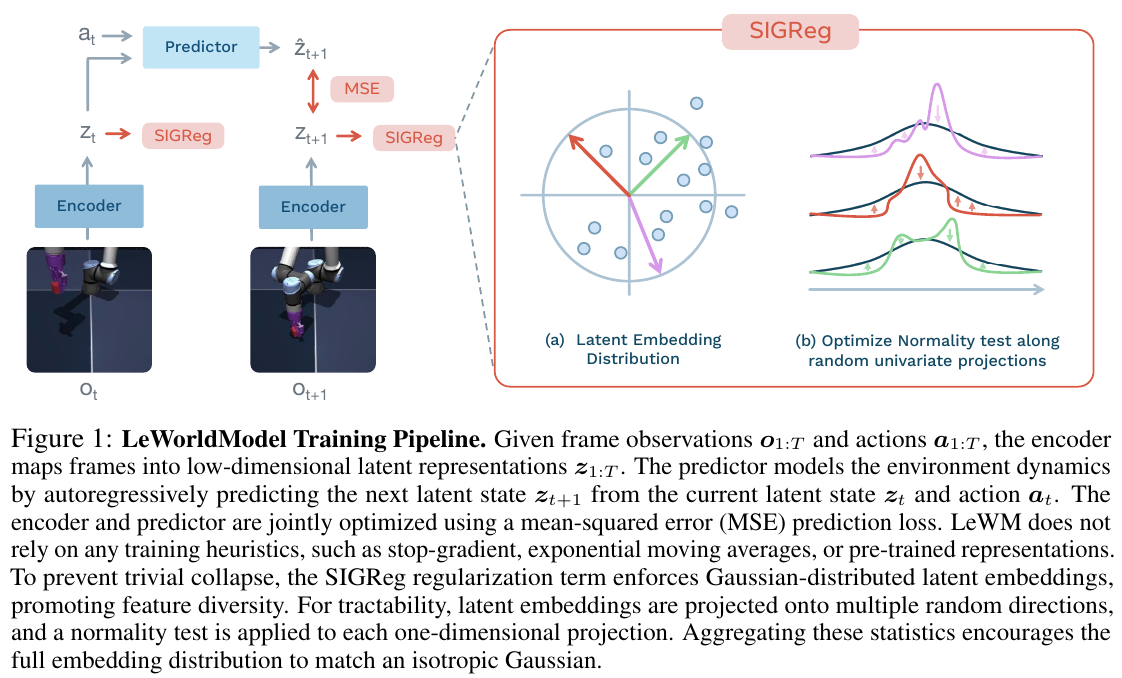
• Figure 1. LeWorldModel training pipeline임.
• Frame observation o₁:ₜ와 action a₁:ₜ가 주어지면 encoder가 frame을 low-dimensional latent representation z₁:ₜ로 변환함.
• Predictor는 현재 latent state zₜ와 action aₜ로부터 다음 latent state zₜ₊₁을 autoregressive하게 예측하여 environment dynamics를 모델링함.
• Encoder와 predictor를 mean-squared error(MSE) prediction loss로 함께 최적화함.
• LeWM은 stop-gradient, exponential moving average, pretrained representation과 같은 training heuristic에 의존하지 않음.
• Trivial collapse를 막기 위해 SIGReg regularization term이 latent embedding의 Gaussian distribution을 유도하여 feature diversity를 높임.
• 계산을 다룰 수 있게 embedding을 여러 random direction으로 projection하고 각 1D projection에 normality test를 적용함.
• 이 statistic을 집계해 전체 embedding distribution이 isotropic Gaussian에 가까워지게 함.
1 Introduction

• Figure 2. Latent world model 접근법의 특징을 training paradigm별로 분류함.
• End-to-end 방법(PLDM)은 pretrained representation이나 stop-gradient/EMA 같은 heuristic 없이 pixel에서 encoder와 predictor를 공동 학습하지만, hyperparameter가 많고 collapse 방지 보장이 없음.
• Foundation-based 방법(DINO-WM)은 pretrained vision encoder를 고정해 collapse를 피하지만 end-to-end 학습을 포기함.
• Task-specific 방법(Dreamer, TD-MPC)은 reward signal이나 privileged state 접근이 필요함.
• LeWM은 세 부류의 장점을 결합하여 end-to-end, task-agnostic, pixel-based, reconstruction-free, reward-free 학습을 제공하고, 하나의 hyperparameter와 증명 가능한 anti-collapse 보장을 갖춤.
• AI의 핵심 목표 중 하나는 사람이 설계한 state representation이나 domain-specific calibration 없이, 주변의 sensory input에서 직접 작동하는 하나의 통합 learning paradigm으로 다양한 task와 environment의 skill을 습득하는 agent를 개발하는 것임.
• Camera는 저렴하고 확장하기 쉬우며 pixel 학습은 raw sensory input부터 action까지 완전한 end-to-end training을 가능하게 하므로 vision이 이 목표에 적합함[1].
• World Models(WMs)는 environment에서 action이 초래할 결과를 예측하도록 학습하는 강력한 방법군임[2].
• 성공적으로 학습한 WM은 agent가 자신의 world model, 즉 imagination space만으로 planning하고 스스로 개선하게 함.
• 이는 environment와 상호작용하지 않고 고정 dataset에서 배워야 하는 offline setting에서 특히 유용하며, model로 synthetic experience를 생성하고 counterfactual action sequence를 평가할 수 있음[3,4].
• 최근 널리 사용되는 world model 학습 접근법은 Joint Embedding Predictive Architecture(JEPA)임[5].
• JEPA는 environment의 모든 측면을 모델링하기보다 future state 예측에 필요한 가장 관련성 높은 feature를 포착하는 데 집중함.
• 구체적으로 observation을 compact low-dimensional latent space에 encode하고 future observation의 latent representation을 예측해 temporal dynamics를 모델링함.
• 하지만 개념적으로 단순한 기존 JEPA도 collapse에 매우 취약함.
• 이 실패에서는 model이 모든 input을 거의 같은 representation으로 매핑해 temporal prediction objective를 자명하게 만족시키므로 representation을 사용할 수 없게 됨.
• 따라서 collapse 방지는 JEPA 학습의 핵심 과제 중 하나임.
• 이를 해결하려는 영향력 있는 연구가 많이 제안됨.
• 그러나 대체로 heuristic regularization, multi-objective loss, 외부 정보, pretrained encoder와 같은 architectural simplification에 의존함.
• 실제로 이러한 전략은 추가 불안정성을 유발하거나 training complexity를 크게 늘리곤 함(Appendix C).
왜 모든 input을 같은 vector로 만들면 문제가 되는가?
• Representation collapse는 서로 다른 observation을 구별할 정보가 embedding에서 사라지는 상태임.
• 설명용으로 공이 왼쪽인 image와 오른쪽인 image를 모두 [0,0]으로 encode하면 predictor는 항상 [0,0]을 출력해 MSE=0을 만들 수 있음.
• 하지만 이 vector로는 공의 위치나 action의 결과를 구별하지 못하므로 planning에 쓸 수 없음.
• Prediction을 쉽게 만드는 힘과 다양한 input을 구별하게 하는 힘을 함께 두어야 하며, 이 논문에서는 후자를 SIGReg가 담당함.
• 이 한계를 극복하기 위해 heuristic 없이 raw pixel에서 안정적 JEPA를 end-to-end로 학습하는 최초의 원리적이고 단순한 방법 LeWorldModel(LeWM)을 제안함(Figure 1).
• 2D/3D environment의 다양한 manipulation, navigation, locomotion task에서 평가함.
• 또한 latent space의 targeted probing과 surprise 정량화로 intuitive physical understanding을 조사함.
• 핵심 결과와 기여는 다음과 같음.
• Single GPU에서 raw pixel로 latent world model을 학습하는 end-to-end JEPA를 제안함.
• 간단하고 안정적인 two-term objective를 사용하며 architecture와 hyperparameter 선택에 robust하고, logarithmic-time hyperparameter search를 가능하게 함.
• 실험에서 compact한 15M-parameter model만으로 다양한 2D/3D task에서 경쟁력 있는 control 성능을 달성함.
• 기존 end-to-end JEPA보다 뛰어나고, 훨씬 적은 비용으로 foundation-model 기반 WM과 경쟁하며 planning을 최대 48배 빠르게 수행함.
• Physical quantity probing과 비물리적 trajectory를 검출하는 violation-of-expectation test로 latent space의 physical understanding을 평가함.
2 Related Work
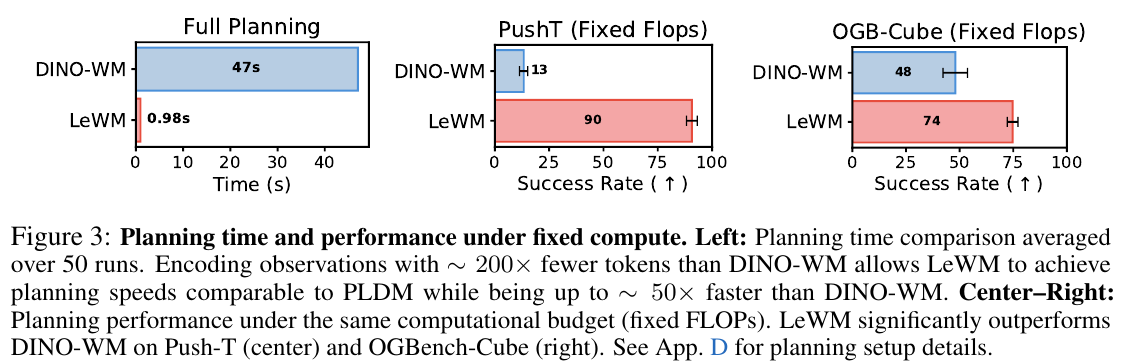
• Figure 3. 고정 compute에서의 planning time과 performance임.
• 왼쪽은 50회 실행을 평균한 planning time 비교임.
• DINO-WM보다 약 200배 적은 token으로 observation을 encode해 PLDM과 비슷한 planning speed를 얻으며 DINO-WM보다 최대 약 50배 빠름.
• 중앙과 오른쪽은 동일한 computational budget, 즉 고정 FLOPs에서의 planning performance임.
• Push-T(중앙)와 OGBench-Cube(오른쪽)에서 LeWM이 DINO-WM을 크게 앞섬.
• Planning setup은 Appendix D에 제시함.
World Models
• data에서 environment dynamics의 predictive model을 학습하여 agent가 imagination에서 future state를 추론하게 함.
• 대표적인 WM 부류는 pixel space에서 dynamics를 명시적으로 모델링하는 generative 접근법임.
• 이 action-conditioned generative model은 과거 state와 action에 조건화해 future observation을 생성하는 learned simulator로 동작함.
• Generative WM은 기존 game-like environment의 simulation에 성공적으로 적용됨.
• 예를 들어 IRIS[3], DIAMOND[6], Δ-IRIS[7], OASIS[8], DreamerV4[4]는 Minecraft, Counter-Strike, Crafter 등의 environment를 모델링해 RL에서 policy sample efficiency를 높임.
• Genie[9], HunyuanWorld[10]와 같이 완전히 새로운 interactive simulator를 생성하는 방법도 있으며 learned simulator는 robot policy evaluation에도 사용됨[11].
• 많은 generative WM은 reward signal을 포함한 dataset에 접근한다고 가정해 downstream RL에 필요한 dynamics와 value-relevant information을 함께 모델링함.
• 반면 본 연구는 reward supervision에 의존하지 않고 observational data에서 generic task-agnostic WM을 학습하려는 JEPA 계열과 같은 reward-free setting에 집중함.
JEPA
• compact low-dimensional latent space에서 system의 dynamic evolution을 예측하는 world model framework임.
• LeCun[5]의 도입 이후 JEPA는 크게 발전했으며, 주로 target task와 non-collapsing representation 학습 전략이 달라짐.
• 대표적 연구 흐름은 masked input patch의 latent embedding을 예측하는 self-supervised representation learning임.
• Image의 I-JEPA[12], video의 V-JEPA[13,14], medical data의 Echo-JEPA와 Brain-JEPA[15,16]가 이에 속함.
• 대체로 target encoder의 exponential moving average(EMA)와 stop-gradient(SG) update를 함께 사용해 training을 안정화하고 representation collapse를 방지함.
• 그러나 EMA와 SG가 일반적으로 well-defined objective의 최소화에 해당하지 않으므로 이론적 이해는 제한적임[17].
• 두 번째 흐름은 action-conditioned latent world modeling에 JEPA recipe를 적용함.
• 일부는 representation을 얻기 위해 pretrained encoder에 의존함[14,18,19,20].
• Collapse는 피하지만 representation의 expressivity가 해당 pretrained encoder에 제한됨.
• 반대로 PLDM[21,22]은 VICReg[23]에 regularization term을 추가해 representation을 end-to-end 학습하나 알려진 training instability와 scalability 한계를 감수함[24].
• 일부 연구는 proprioceptive input이나 action decoder 등 auxiliary signal/architectural component로 안정성을 더 높임[18,19].
• 본 연구는 future embedding prediction objective와 embedding이 Gaussian distribution을 따르게 하는 regularization objective[25]라는 간단한 두 loss로 raw pixel에서 end-to-end JEPA를 안정적으로 학습함.
Planning with Latent Dynamics.
• World Models[26]는 high-dimensional observation의 compact latent representation에서 직접 policy를 학습하는 접근을 개척함.
• 일부 연구는 learned latent dynamics model로 RL policy를 학습함[27,28,29,4].
• 이때 generative WM이 imagination에서 trajectory를 rollout하는 simulator로 동작하여 policy optimization 대부분을 latent imagination space에서 수행함.
• 학습 후에는 policy를 직접 실행하며 test time에는 WM이 더 이상 필요하지 않음.
• 더 최근의 연구는 Model Predictive Control(MPC)을 이용해 test time에 latent space에서 직접 planning함[30,31,32,33,18,22].
World model로 policy를 학습하는 것과 MPC는 어떻게 다른가?
• Policy는 observation에서 action을 바로 선택하는 함수이며, MPC는 현재 observation에서 여러 future action sequence를 비교하는 planning 방식임.
• 설명용으로 robot이 물체를 밀 때 policy는 바로 왼쪽 action을 출력하지만 MPC는 왼쪽·오른쪽 등 여러 sequence를 model에서 rollout해 goal에 가까운 것을 고름.
• 실제 action을 실행하고 새 observation을 얻으면 MPC는 다시 planning하므로 model error의 누적을 줄일 수 있음.
• LeWM의 평가에서는 학습한 WM을 test time에도 사용하며, policy만 실행하는 방법과 inference compute를 비교할 때 이 차이를 고려해야 함.
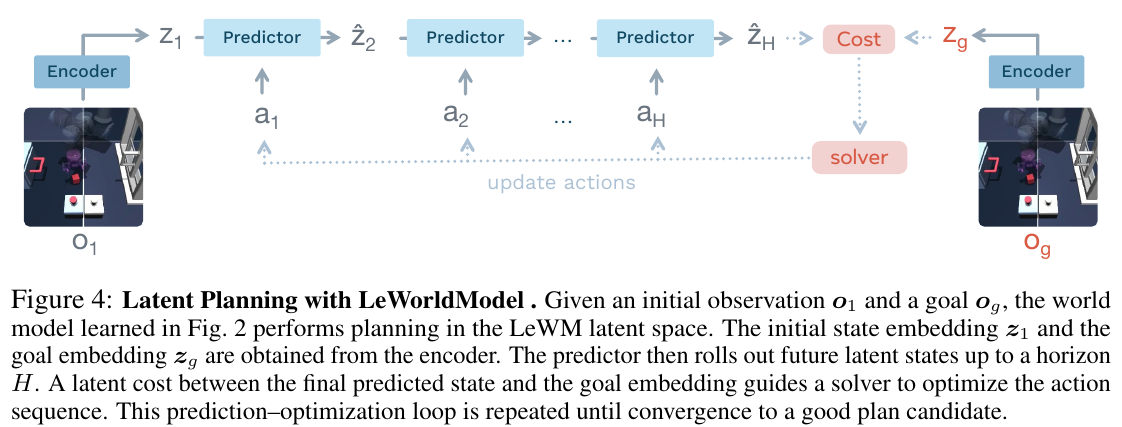
• Figure 4. LeWorldModel을 이용한 latent planning임.
• Initial observation o₁과 goal o_g가 주어지면 Figure 2에서 학습한 world model로 LeWM latent space에서 planning함.
• Encoder에서 initial state embedding z₁과 goal embedding z_g를 얻음.
• Predictor가 horizon H까지 future latent state를 rollout함.
• 마지막 predicted state와 goal embedding 사이 latent cost가 solver의 action sequence 최적화를 이끎.
• 좋은 plan candidate로 수렴할 때까지 이 prediction–optimization loop를 반복함.
3 Method: LeWorldModel
• 이 절에서 LeWorldModel(LeWM)을 소개함.
• 먼저 dataset, model architecture, training objective를 포함해 offline data에서 latent WM을 학습하는 간결한 절차를 설명함.
• 이어 학습한 model을 MPC 기반 latent planning으로 의사결정에 사용하는 방법을 설명함.
3.1 Learning the Latent World Model
Offline Dataset.
• 완전한 offline 및 reward-free setting을 다룸.
• LeWorldModel은 reward signal이나 task specification 없이 annotation 없는 observation/action trajectory만으로 학습함.
• 이는 observational data에서 generic task-agnostic WM을 학습하려는 JEPA 계열[18,14]과 일치함.
• 목표는 특정 task의 behavior 최적화가 아니라 environment dynamics를 포착하고 나중에 다양한 task에 맞춰 control/adaptation할 수 있는 representation 학습임.
• Training data는 raw pixel observation o₁:ₜ와 관련 action a₁:ₜ로 이루어진 길이 T의 trajectory임.
• Trajectory는 최적성 조건 없는 behavior policy로 offline 수집하며, dynamics를 충분히 cover한다면 pseudo-expert 또는 exploratory policy 모두 가능함.
• Batch size, resolution, sub-trajectory 구성 등 추가 구현 사항은 Appendix D에 제시함.
Model Architecture.
• LeWM은 encoder와 predictor의 두 component로 구성됨.
• Encoder는 frame observation oₜ를 compact low-dimensional latent representation zₜ로 매핑함.
• Predictor는 latent embedding zₜ와 action aₜ를 받아 다음 frame observation의 embedding ẑₜ₊₁을 예측함으로써 latent space에서 dynamics를 모델링함.
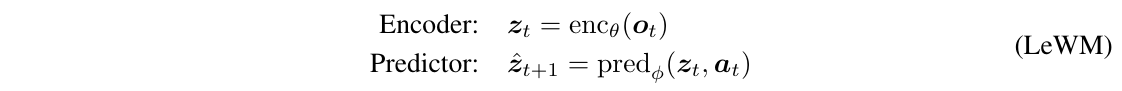
• Encoder는 Vision Transformer(ViT)[34]로 구현함.
• 별도 언급이 없으면 patch size 14, 12 layer, 3 attention head, hidden dimension 192의 tiny configuration(약 5M parameter)을 사용함.
• 마지막 layer의 [CLS] token embedding에 projection을 적용해 observation embedding zₜ를 구성함.
• Projection은 Batch Normalization[35]을 갖는 1-layer MLP로 [CLS] embedding을 새 representation space에 매핑함.
• 최종 ViT layer의 Layer Normalization[36]이 anti-collapse objective의 효과적 최적화를 방해하므로 이 단계가 필요함.
CLS token 뒤에 projector가 왜 필요한가?
• CLS token은 image patch들의 정보를 모아 하나의 vector로 표현하는 token임.
• Layer Normalization은 각 sample vector 내부의 mean과 scale을 정규화하며, SIGReg는 여러 sample의 embedding distribution 전체에 원하는 형태를 요구함.
• 설명용으로 vector별 길이와 평균을 강하게 고정하면 Gaussian처럼 다양한 길이와 좌표 조합을 갖는 distribution을 표현하기 어려울 수 있음.
• 논문은 ViT 뒤에 Batch Normalization을 갖춘 MLP projection을 두어, final LayerNorm의 제약이 anti-collapse objective 최적화를 방해하는 문제를 완화함.
• Predictor는 6 layer, 16 attention head, 10% dropout의 transformer(약 10M parameter)임.
• 각 layer에 Adaptive Layer Normalization(AdaLN)[37]을 적용해 action을 반영함.
• AdaLN parameter를 zero로 초기화하여 training을 안정화하고 action conditioning의 영향이 점진적으로 나타나게 함.
• N개 frame representation의 history를 입력받아 autoregressive하게 다음 frame representation을 예측하며, future embedding을 보지 못하도록 temporal causal masking을 사용함.
• Predictor 뒤에도 encoder와 동일한 구현의 projector network를 둠.
• World model의 모든 component는 다음 문단의 loss로 공동 학습함.
AdaLN과 causal masking은 각각 무엇을 하는가?
• AdaLN은 conditioning input으로 Layer Normalization의 scale/shift 등을 조절하는 방식이며 여기서는 action 정보를 predictor에 주입함.
• 설명용으로 같은 image라도 왼쪽으로 미는 action과 오른쪽으로 미는 action이면 다른 next state가 필요하므로 action에 따라 feature 처리가 달라져야 함.
• Causal mask는 시간 t의 prediction이 t보다 미래의 embedding을 보지 못하게 attention 연결을 제한함.
• Training 때 정답 future를 몰래 보아 생기는 shortcut을 막고 실제 autoregressive planning 조건에 맞추는 역할임.
Training Objective.
• 목표는 future prediction, 즉 environment dynamics modeling에 유용한 latent representation 학습임.
• LeWorldModel의 objective는 prediction loss와 regularization loss의 합임.
• Teacher-forcing prediction loss L_pred는 연속 timestep 사이 predicted embedding의 오차를 다음과 같이 계산함.
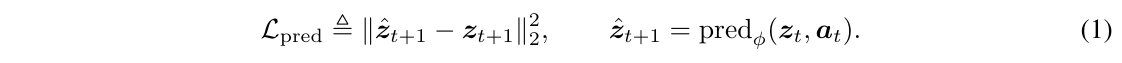
• Prediction loss는 encoder가 predictor에 예측하기 쉬운 representation을 학습하게 유도함.
• 그러나 식 (1)만 사용하면 encoder가 모든 input을 constant representation으로 매핑하는 trivial solution, 즉 representation collapse가 발생함.
• 이를 막기 위해 embedding space의 feature diversity를 높이는 anti-collapse regularization term을 도입함.
• 단순성, scalability, stability를 이유로 Sketched-Isotropic-Gaussian Regularizer(SIGReg)[25]를 채택함.
• SIGReg는 latent embedding이 isotropic Gaussian target distribution을 따르도록 유도함.
• Z∈ℝᴺˣᴮˣᵈ는 history length N, batch size B에서 모은 embedding tensor이며 d는 embedding dimension임.
• 기존 normality test 대부분은 univariate data용이어서 dimension이 커질 때 안정적으로 확장되지 않으므로 high-dimensional normality의 직접 평가는 어려움.
• SIGReg는 embedding을 M개의 random unit-norm direction u⁽ᵐ⁾∈Sᵈ⁻¹에 projection하고, Figure 1처럼 1D projection h⁽ᵐ⁾=Zu⁽ᵐ⁾의 univariate Epps–Pulley[38] statistic T(·)를 최적화하여 이 한계를 우회함.
• Cramér–Wold theorem[39]에 따르면 모든 1D marginal의 일치는 full joint distribution의 일치와 동치임.
1D projection만 검사해도 high-dimensional Gaussian을 알 수 있는가?
• Isotropic Gaussian N(0,I)는 방향에 따른 covariance 차이가 없는 Gaussian이며 각 unit direction으로 본 projection은 N(0,1)을 따름.
• 설명용으로 2D point cloud를 가로·세로·대각선에 비춰 1D histogram을 확인하는 것과 비슷함.
• Cramér–Wold theorem은 모든 direction의 distribution이 일치하면 joint distribution도 일치한다고 말함.
• 실제 SIGReg는 유한한 M개 random direction과 finite batch를 사용하므로 이론의 모든 direction/극한 조건을 정확히 검사하는 것은 아님.
• 따라서 theorem의 asymptotic 성질과 실험에서 관찰한 안정성을 구별해 이해해야 함.
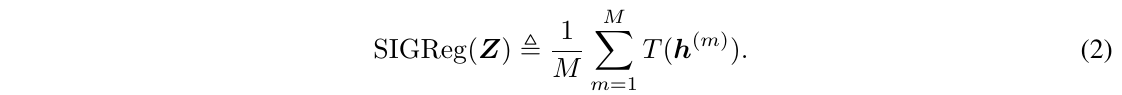
• SIGReg와 Epps–Pulley statistical test 정의의 추가 내용은 Appendix A에 제시함.
• 전체 LeWM training objective를 다음과 같이 정의함.
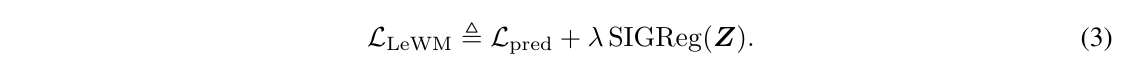
• 이 방법의 training hyperparameter는 SIGReg의 random projection 수 M과 regularization weight λ의 두 개뿐임.
• 별도 언급이 없으면 M=1024, λ=0.1을 사용함.
• 실제로 projection 수가 downstream performance에 미치는 영향은 무시할 수준이어서(Section 4, Appendix G), λ만 실질적으로 tuning하면 됨.
• 이에 따라 hyperparameter 선택이 크게 단순해지며 logarithmic complexity의 간단한 bisection search로 λ를 효율적으로 최적화할 수 있음.
• Stop-gradient, EMA, 추가 stabilization heuristic을 사용하지 않음.
• Loss의 모든 component로 gradient를 전달하고 모든 parameter를 공동으로 end-to-end 최적화하므로 간결하고 구현하기 쉬움.
• Training logic은 Algorithm 3에 요약함.
3.2 Latent Planning
• Inference time에는 Figure 4처럼 world model의 latent space에서 trajectory optimization을 수행함.
• Initial observation o₁이 주어지면 candidate action sequence를 random 초기화하고 planning horizon H까지 predicted latent state를 반복 rollout함.
• Model의 latent transition 예측은 다음과 같음.
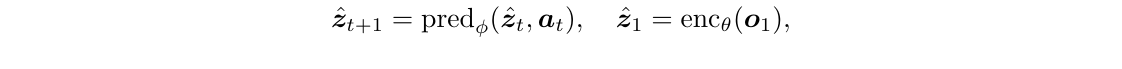
• Terminal latent goal-matching objective를 최소화하도록 action sequence를 최적화하여 planning함.
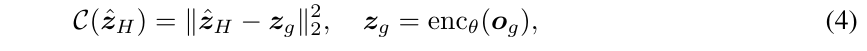
• ẑ_H는 rollout 끝의 predicted latent state이며 z_g는 goal observation o_g의 embedding임.
• Planning 중 WM parameter는 고정함.
• 이 절차는 다음 finite-horizon optimal control problem에 해당함.
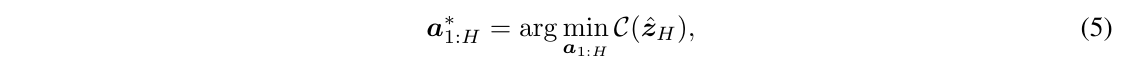
• 최적 plan을 반복 선택하고 best plan의 statistic으로 sampling distribution parameter를 갱신하는 sampling 방법 Cross-Entropy Method(CEM)[40]로 이 문제를 풂.
• Planning horizon H는 장기 lookahead와 증가하는 compute/model bias 사이 trade-off를 결정함.
• 특히 autoregressive rollout은 horizon이 커질수록 prediction error를 누적해 최적화한 action sequence의 quality를 떨어뜨릴 수 있음.
• 이를 완화하기 위해 MPC를 사용하여 계획한 action 중 처음 K개만 실행하고 갱신된 observation에서 다시 planning함.
• 자세한 planning strategy는 Appendix D에 제시함.
CEM은 어떻게 action을 고르고, MPC는 왜 다시 계획하는가?
• CEM은 action sequence를 여러 개 sampling하고 cost가 낮은 elite의 평균/분산 쪽으로 다음 sampling distribution을 옮기는 optimizer임.
• 설명용으로 100개 plan 중 goal에 가장 가까운 10개를 남기면 다음에는 그 주변 plan을 더 자주 탐색함.
• MPC는 최적 plan의 처음 일부 action만 실행한 다음 실제 observation을 다시 encode하여 재계획하는 control 방식임.
• Prediction error가 long rollout에 누적되는 문제를 줄일 수 있지만, CEM은 non-convex problem의 global optimum을 보장하지 않음.
• 본 논문의 실제 sample 수와 iteration/horizon은 Appendix B/D에 따로 주어지며 설명용 숫자와 구별함.
4 Latent Planning Performance
4.1 Planning evaluation setup
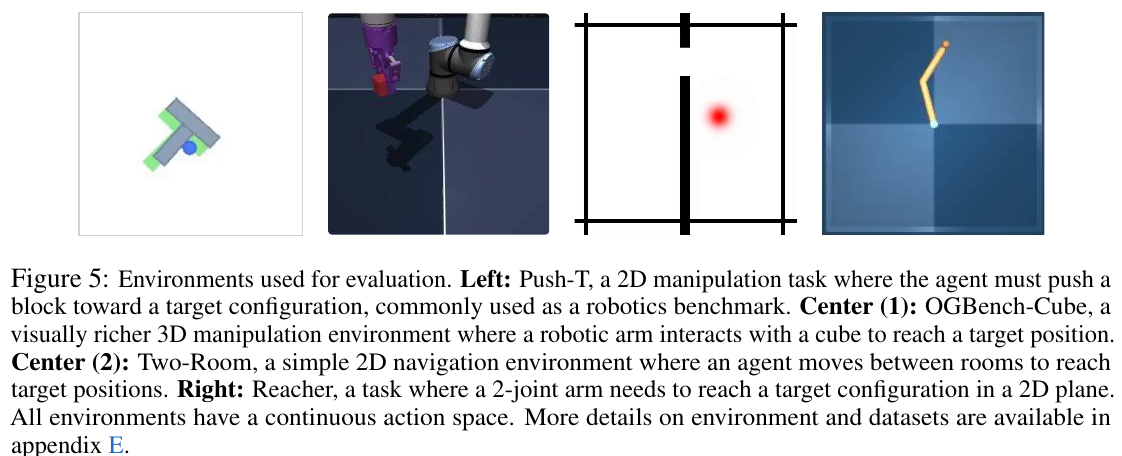
• Figure 5. 평가 environment임.
• 왼쪽 Push-T는 agent가 block을 target configuration으로 밀어야 하는 2D manipulation task이며 흔히 사용하는 robotics benchmark임.
• 중앙 (1) OGBench-Cube는 robot arm이 cube와 상호작용해 target position에 도달하는, 시각적으로 더 풍부한 3D manipulation environment임.
• 중앙 (2) Two-Room은 agent가 target position으로 이동하려고 room 사이를 이동하는 단순한 2D navigation environment임.
• 오른쪽 Reacher는 2-joint arm이 2D plane에서 target configuration에 도달하는 task임.
• 모든 environment의 action space는 continuous임.
• Environment와 dataset 세부 사항은 Appendix E에 제시함.
Environments.
• Figure 5의 2D/3D environment에서 navigation, motion planning, manipulation을 포함한 다양한 task로 LeWM을 평가함.
• Dataset generation과 environment 세부 사항은 Appendix E에 제시함.
Baselines.
• LeWM을 두 state-of-the-art JEPA 방법 DINO-WM[18]/PLDM[22], goal-conditioned behavioral cloning policy(GCBC), 두 goal-conditioned offline RL algorithm GCIVL/GCIQL[41]과 비교함.
• PLDM도 pixel observation에서 WM을 직접 end-to-end 학습하므로 가장 가까운 setting임.
• 다만 VICReg[23]에서 유래한 seven-term objective가 training instability를 유발하고 hyperparameter tuning을 복잡하게 함.
• 반면 DINO-WM은 DINOv2[42] feature encoder로 collapse를 완화하지만 원래 formulation에는 proprioceptive input 등의 다른 modality도 포함됨.
• 공정한 비교를 위해 별도 언급이 없으면 DINO-WM에서 proprioceptive information을 제외함.
• Baseline 구현은 Appendix C, evaluation setting은 Appendix F.1에 제시함.
• 각 방법의 hyperparameter는 모든 environment에서 고정함.
4.2 Towards Efficient Planning with WMs
• Planning performance를 Figure 6에 제시함.
• LeWM은 더 어려운 planning task에서 PLDM을 앞서고 PushT success rate가 18% 더 높으며 DINO-WM과도 경쟁력 있음.
• 특히 PushT에서 pixel-only LeWM이 추가 proprioceptive information을 사용하는 DINO-WM도 앞서므로, task-relevant underlying quantity를 포착할 수 있음을 보임.
• 흥미롭게도 가장 단순한 Two-Room에서는 성능이 더 낮음.
• 낮은 dataset diversity와 intrinsic dimensionality 때문에 encoder가 high-dimensional latent space에서 SIGReg의 isotropic Gaussian prior에 맞추기 어렵고, 그 결과 representation의 구조가 약해질 수 있다는 설명이 가능함.
• 이는 매우 낮은 complexity의 environment에서 SIGReg가 가질 수 있는 한계를 보여줌.
성공률이 18% 높다는 표현은 무엇과 비교하는가?
• 이 문장은 PushT의 PLDM 대비 결과를 말하며 원문이 18% higher라고 서술한 표현을 유지함.
• Percentage point는 두 success rate의 단순 차이이고 relative percent는 baseline으로 나눈 증가율이므로 서로 다름.
• Figure 6의 각 method/setting을 확인하면서 읽어야 하며, pixel-only LeWM과 proprioception을 추가로 쓰는 DINO-WM 비교 조건도 구별해야 함.
• 또한 TwoRoom에서 성능이 낮다는 예외도 함께 제시되어 모든 environment에서 항상 우수하다고 일반화할 수 없음.
• Planning speedup 비교(Figure 3)에서 LeWM은 최대 48배 빠르며, task 전반의 경쟁력 있는 성능을 유지하면서 전체 planning을 1초 미만에 완료함.
• Planning setup이 고정되어 있으면 이 시간은 environment가 달라도 일정하여 real-time control과의 격차를 줄임.
4.3 Towards Stable Training of World Models
Ablations.
• LeWM의 여러 design choice에 ablation을 수행함.
• 먼저 SIGReg 내부 parameter인 random projection 수와 integration knot 수의 sensitivity를 분석함.
• 두 수량은 performance에 큰 영향을 주지 않아 세심한 tuning이 필요하지 않음.
• 따라서 regularization weight λ만 실질적인 hyperparameter로 남음.
• 한 개만 tuning하므로 간단한 bisection strategy O(log n)로 효율적 grid search가 가능한 반면 PLDM은 polynomial-time search O(n⁶)가 필요함.
• Embedding dimension의 영향도 조사함.
• 잘 작동하려면 representation dimension이 충분히 커야 하지만 일정 threshold 이후 performance가 빠르게 포화하므로 encoder capacity의 정확한 선택에는 robust함.
• 기본 ViT encoder를 ResNet-18로 바꾸어 architecture 영향도 검토함(Table 8).
• 두 architecture 모두 경쟁력 있는 성능을 보이므로 vision encoder 선택에 크게 의존하지 않음.
• 모든 ablation 세부 사항은 Appendix G에 제시함.
Hyperparameter search의 O(log n)은 어떤 가정인가?
• Bisection은 탐색 구간을 반복해서 반으로 줄이는 절차여서 n개 구간 규모를 좁히는 데 logarithmic 단계가 걸림.
• 다만 일반적인 non-monotonic validation performance의 global optimum을 항상 찾는다는 보장은 이 표현만으로 얻지 못함.
• 6개 weight 각각 n개 후보를 모두 조합하면 n⁶개의 exhaustive grid가 필요하다는 비교임.
• 본문의 search efficiency 주장은 tuning할 loss weight가 크게 줄었다는 맥락으로 읽어야 하며, 모든 training hyperparameter가 하나라는 뜻은 아님.
Training Curves.
• PushT에서 LeWM의 training loss curve는 Figure 18, PLDM은 Figure 19에 제시함.
• LeWM의 two-term objective는 부드럽고 단조롭게 수렴하며, prediction loss는 꾸준히 감소하고 SIGReg는 초기에 급락한 뒤 plateau에 도달하여 latent distribution이 isotropic Gaussian target에 빠르게 접근함을 보임.
• 반면 PLDM의 seven-term objective는 여러 loss component에서 noisy/non-monotonic behavior를 보임.
• 잘 동작하는 두 term만으로 objective를 줄이면 training이 크게 안정화되고 여러 regularizer의 경쟁하는 gradient를 조율할 필요가 사라진다는 LeWM의 장점을 보여줌.
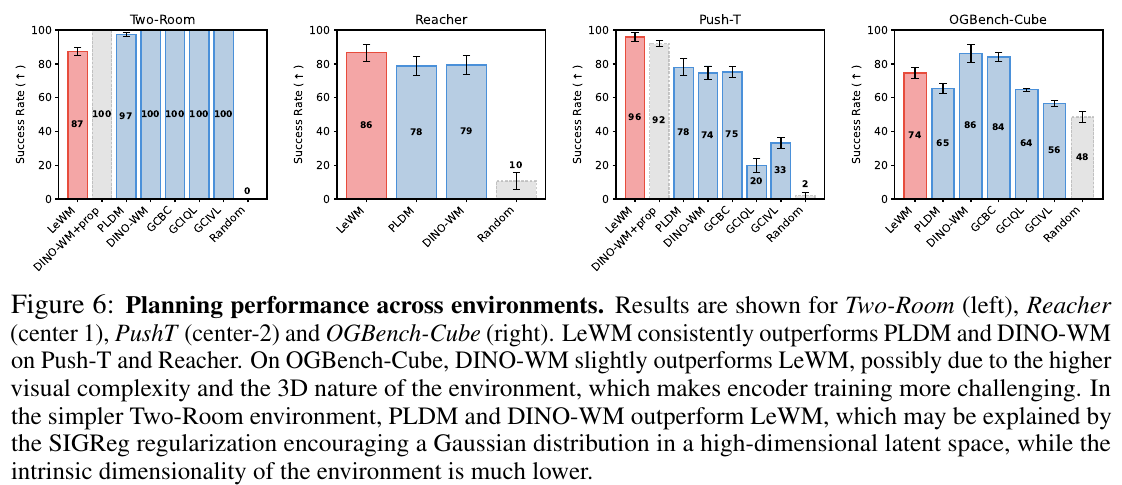
• Figure 6. Two-Room(왼쪽), Reacher(중앙 1), PushT(중앙 2), OGBench-Cube(오른쪽)의 planning performance임.
• LeWM은 Push-T와 Reacher에서 PLDM/DINO-WM을 일관되게 앞섬.
• OGBench-Cube에서는 DINO-WM이 약간 더 우수한데, 더 높은 visual complexity와 3D 특성으로 encoder 학습이 어려워지기 때문일 수 있음.
• 단순한 Two-Room에서는 PLDM/DINO-WM이 LeWM보다 뛰어나며, environment intrinsic dimension은 훨씬 낮은데 SIGReg가 high-dimensional Gaussian distribution을 유도하기 때문일 수 있음.
5 Quantifying Physical Understanding in LeWM
• Latent embedding에서 physical quantity를 추출하도록 학습하거나 physics 변화 검출 능력을 측정하여 LeWM latent space가 포착한 dynamics의 quality를 평가함.
5.1 Physical Structure of the Latent Space
Probing physical quantities.
• Physical understanding의 첫 측정으로 LeWM representation에서 어떤 physical quantity를 복원할 수 있는지 평가함.
• 주어진 embedding에서 관심 physical quantity를 예측하는 linear/non-linear probe를 모두 학습함.
• Push-T 결과는 Table 1에 제시함.
• LeWM은 PLDM을 일관되게 앞서며 DINOv2 같은 large pretrained model의 representation과도 경쟁력 있음.
• 다른 environment의 probing 결과는 Appendix F.2에 제시함.
Linear probe가 잘 된다는 것은 physics를 이해했다는 뜻인가?
• Probe는 frozen representation에서 별도 작은 model을 학습해 position/angle 등 label을 얼마나 예측할 수 있는지 검사함.
• Linear probe는 linear map으로 쉽게 꺼낼 수 있는 정보인지, non-linear probe는 더 복잡하게 얽힌 정보도 있는지 확인함.
• 설명용으로 embedding에서 x-position을 잘 읽을 수 있어도 충돌 법칙 전체를 이해하거나 모든 unseen situation을 해결한다고 보장하지는 않음.
• 그래서 이 논문은 probing 외에도 control과 VoE를 함께 평가하며, probe 학습에 사용한 label을 WM pretraining supervision과 혼동하면 안 됨.
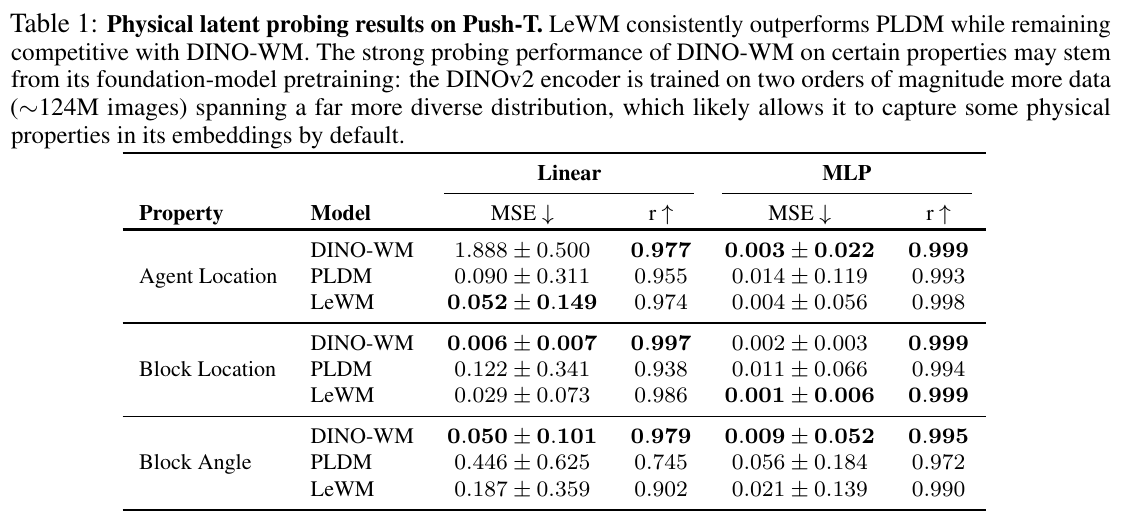
• Table 1. Push-T의 physical latent probing 결과임.
• LeWM은 PLDM을 일관되게 앞서며 DINO-WM과 경쟁력 있음.
• 일부 property에서 DINO-WM의 probing이 강력한 것은 foundation-model pretraining 때문일 수 있음.
• DINOv2 encoder는 약 124M image라는 약 100배 규모 더 많은 data와 훨씬 다양한 distribution으로 학습하므로 일부 physical property를 embedding에 기본적으로 담을 가능성이 있음.
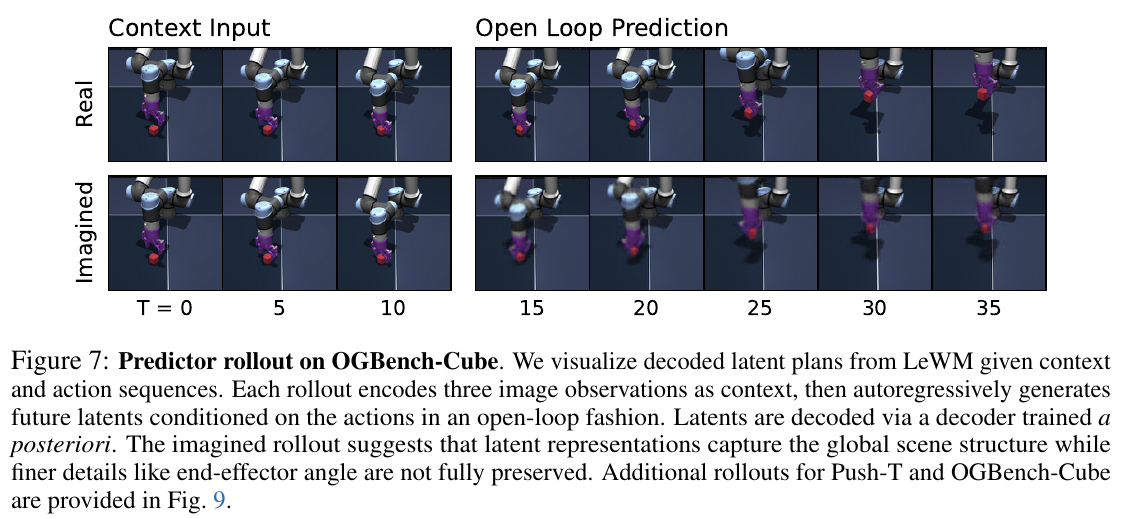
• Figure 7. OGBench-Cube에서 context/action sequence가 주어졌을 때 LeWM latent plan을 decode한 predictor rollout임.
• 각 rollout은 3개 image observation을 context로 encode한 다음 action에 조건화해 open-loop autoregressive future latent를 생성함.
• Latent는 사후에 학습한 decoder로 decode함.
• 상상한 rollout은 global scene structure를 포착하지만 end-effector angle 같은 세부 정보는 완전히 보존하지 못함을 시사함.
• Push-T와 OGBench-Cube의 추가 rollout은 Figure 9에 제시함.
Decoding Latent Space.
• Latent representation이 담은 정보를 더 평가하기 위해 training 중 single 192-dimensional embedding에서 pixel observation을 reconstruct하도록 학습한 decoder의 image를 Figure 10에 제시함.
• WM training에는 reconstruction을 사용하지 않지만 decoder는 learned representation에서 visual scene을 복원할 수 있으므로 compact low-dimensional space가 underlying physical state의 정보를 충분히 보존함을 확인함.
• Decoder architecture는 Appendix D에 제시함.
Decoder visualization이 있는데 왜 reconstruction-free라고 하는가?
• Reconstruction-free는 WM의 encoder/predictor 학습 objective에 pixel reconstruction을 사용하지 않는다는 뜻임.
• 학습한 embedding이 어떤 정보를 담는지 검사하려고 별도 decoder를 학습하는 것은 다른 평가 절차임.
• 설명용으로 저장된 숫자 vector에서 물체 위치가 보이는 image를 복원해 보면 representation에 남은 정보를 살펴볼 수 있음.
• 따라서 decoder image는 WM이 직접 pixel을 생성하도록 학습했다는 증거가 아니며, 흐릿한 세부 정보와 global scene structure를 구별해 해석해야 함.
Visualizing Latent Space.
• t-SNE로 latent space structure를 추가 시각화함.
• Figure 13은 PushT latent space의 qualitative visualization임.
• Learned representation이 environment의 spatial structure를 포착하고 neighborhood relationship과 relative position을 latent space에서 보존함을 시사함.
Temporal Latent Path Straightening.
• Neuroscience의 temporal straightening hypothesis[43]와 최근 연구[44,45]에서 착안해, training 동안 연속 latent velocity vector의 cosine similarity를 측정함(식 9).
• 명시적 regularization 없이도 PushT에서 LeWM latent trajectory가 training에 따라 점점 직선화되는 emergent phenomenon을 관찰함(Figure 17).
• 특히 dedicated temporal smoothness regularizer를 사용하는 PLDM보다 LeWM의 temporal straightness가 더 높음.
• 세부 내용은 Appendix H에 제시함.
5.2 Violation-of-expectation Framework
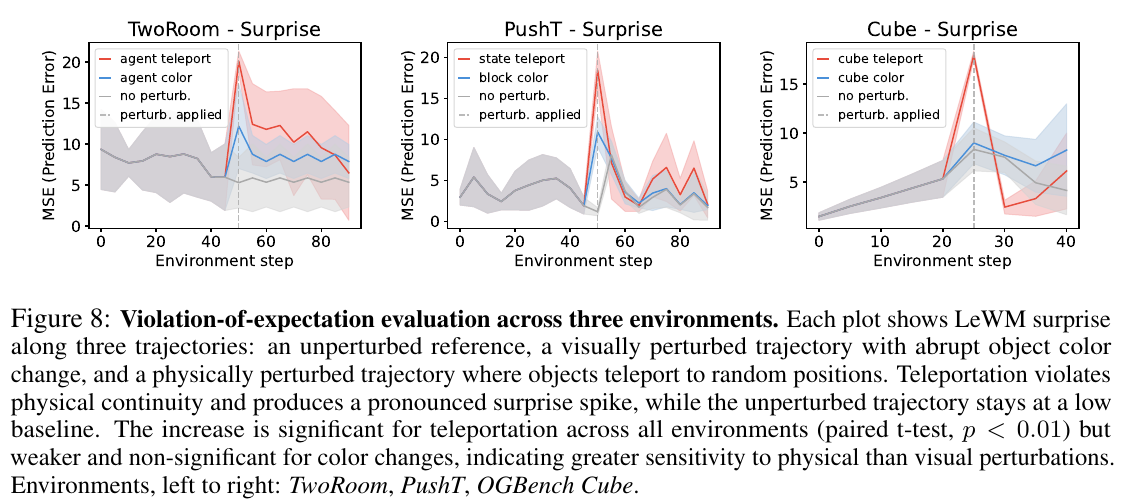
• Figure 8. 세 environment의 violation-of-expectation 평가임.
• 각 plot은 unperturbed reference, object color가 갑자기 변하는 visual perturbation, object가 random position으로 teleport하는 physical perturbation이라는 세 trajectory의 LeWM surprise를 보임.
• Teleportation은 physical continuity를 위반해 뚜렷한 surprise spike를 만들지만 unperturbed trajectory는 낮은 baseline을 유지함.
• 모든 environment에서 teleportation의 증가는 유의함(paired t-test, p<0.01).
• Color change의 증가는 더 약하고 유의하지 않아 visual perturbation보다 physical perturbation에 더 민감함을 나타냄.
• 왼쪽부터 TwoRoom, PushT, OGBench Cube임.
• Physical understanding을 정량화하는 또 다른 접근은 learned WM 위반의 검출 능력임.
• Developmental psychology에서 사용되고 최근 ML에도 도입된 violation-of-expectation(VoE) paradigm[46,47,48]에서 착안해, 학습한 physical regularity에 어긋나는 사건에 더 높은 surprise를 부여하는지 평가함.
• 선행 연구를 따라 predicted future observation과 실제 future observation의 discrepancy로 surprise를 정량화함.
• TwoRoom, PushT, OGBench Cube의 세 environment에서 평가함.
• 각 environment에 두 perturbation을 도입함.
• 첫째 visual perturbation은 trajectory 중 object color가 갑자기 바뀌는 것임.
• 둘째 physical perturbation은 하나 이상의 object를 random location으로 teleport하여 예상되는 scene physical continuity를 위반하는 것임.
• Figure 8은 LeWM이 unperturbed counterpart보다 physical violation frame에 일관되게 더 높은 surprise를 부여함을 보임.
• VoE 세부 사항은 Appendix F.3에 제시함.
Surprise spike만으로 물리 법칙을 배웠다고 단정할 수 있는가?
• 여기서 surprise는 예측한 future와 관측한 future의 discrepancy를 수치화한 signal임.
• Teleportation은 위치가 갑자기 불연속적으로 변하므로 학습한 transition에서 벗어나 큰 error가 생길 수 있음.
• 반대로 color만 바뀌어도 image는 달라지므로, color perturbation과 teleportation을 대조해 단순 visual 변화에 대한 반응과 구별함.
• 본 결과는 실험한 세 environment와 perturbation에서의 sensitivity를 보여주며 모든 physics rule에 대한 일반적 이해를 증명하지는 않음.
6 Conclusion
• 안정적인 end-to-end latent WM 학습 방법 LeWorldModel(LeWM)을 제안함.
• Encoder가 image observation을 latent space에 매핑하고 predictor가 action에 조건화해 future embedding을 예측하는 JEPA임.
• Raw pixel input의 continuous control environment에서 task performance의 경쟁력을 유지하면서 data efficiency, planning time, training time, stability에서 이전 접근법을 앞섬.
• Collapse 방지를 위해 embedding을 isotropic Gaussian으로 명시적으로 유도하는 것이 안정성의 원천이며, 기존 방법에 대해 scalable하고 principled한 대안을 제공함.
Limitations & Future Work.
• 몇 가지 한계가 향후 연구 방향을 제시함.
• Planning이 short horizon에 제한되므로 long-horizon reasoning을 위한 hierarchical WM이 필요함.
• 또한 충분한 coverage의 offline dataset에 의존하며, 특히 diversity가 낮고 단순한 low-dimensional environment에서는 high-dimensional Gaussian prior matching이 어려워 SIGReg가 약해짐.
• 크고 다양한 video dataset의 pretraining이 더 강한 prior를 제공하고 domain-specific data 요구를 줄일 수 있음.
• 마지막으로 inverse dynamics modeling으로 action label 의존성을 완화할 수 있음.