arXiv · 2025.11
Abstract
- 세계와 그 dynamics를 조작 가능한 representation으로 학습하는 것은 AI의 핵심임.
- Joint-Embedding Predictive Architectures(JEPAs)는 유망한 설계도이지만, 실용적 지침과 이론이 부족하여 ad-hoc R&D에 의존하게 되었음.
- JEPA에 대한 포괄적인 이론을 제시하고, 이를 간결하고 확장 가능하며 이론적 근거가 있는 학습 objective인 LeJEPA로 구체화함.
- 첫째, downstream prediction risk를 최소화하기 위해 JEPA embedding이 따라야 하는 최적 분포가 isotropic Gaussian임을 밝힘.
- 둘째, embedding이 이 이상적인 분포에 도달하도록 제약하는 새로운 objective인 Sketched Isotropic Gaussian Regularization(SIGReg)을 제안함.
- JEPA predictive loss와 SIGReg를 결합한 LeJEPA는 (i) 하나의 trade-off hyperparameter, (ii) 선형 time·memory complexity, (iii) hyperparameter·architecture(ResNets, ViTs, ConvNets)·domain 전반의 안정성, (iv) stop-gradient·teacher–student·hyperparameter scheduler 등이 없는 heuristic-free 구성, (v) 약 50줄의 코드로 구현되는 distributed training 친화성이라는 이론적·실용적 이점을 가짐.
- 실증 검증은 규모와 domain이 서로 다른 10개 이상의 dataset, 60개 이상의 architecture를 포함함.
- 예를 들어 ImageNet-1K에서 pretraining하고 backbone을 고정한 linear evaluation을 수행하면 ViT-H/14에서 79%에 도달함.
- LeJEPA의 단순성과 이론 친화적인 연구 환경이 self-supervised pretraining을 AI 연구의 핵심 축으로 다시 정착시키기를 기대함(GitHub repo).
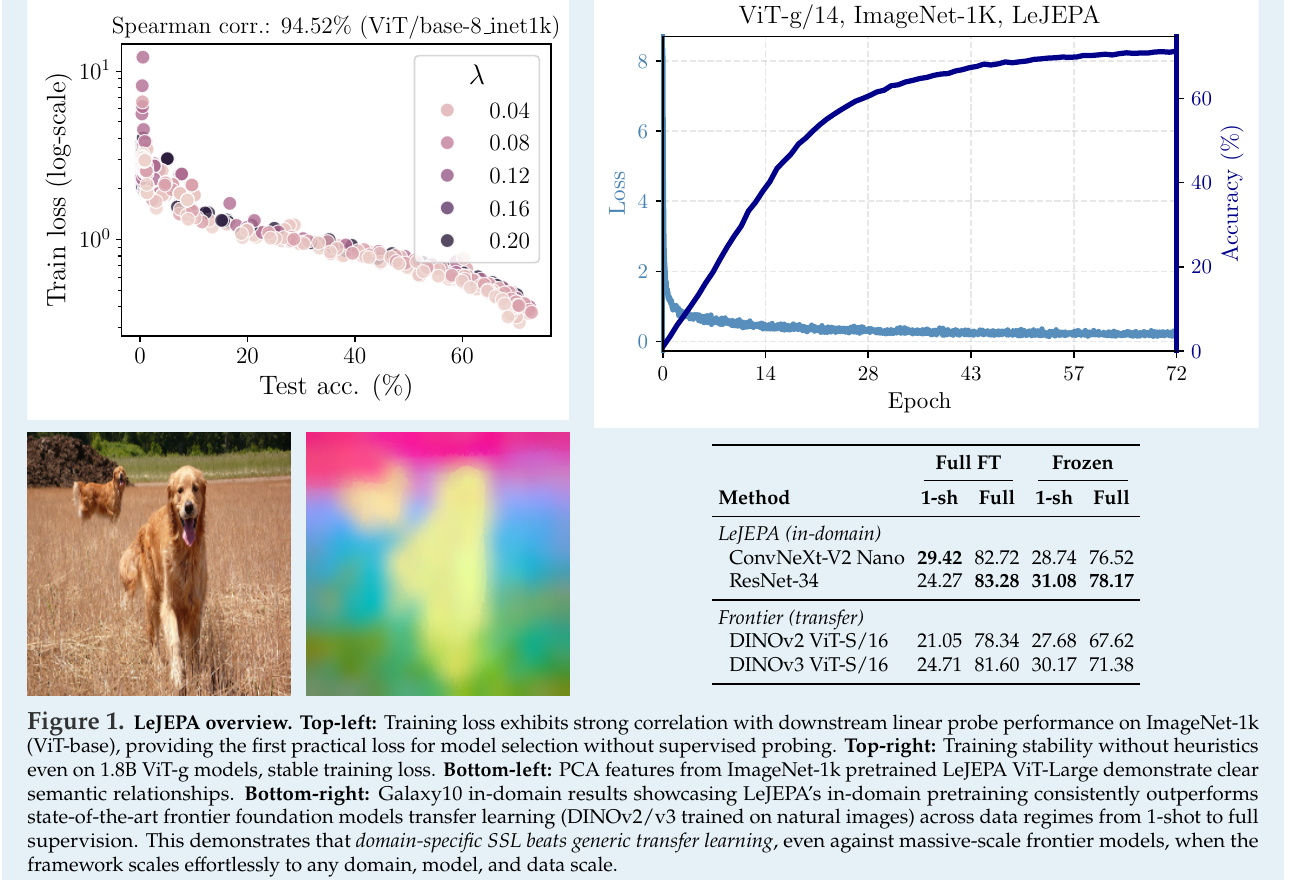
- Figure 1. LeJEPA의 개요임.
- 왼쪽 위: ImageNet-1K의 ViT-base에서 training loss와 downstream linear probe 성능이 강하게 상관되어, supervised probing 없이 model selection에 사용할 수 있는 최초의 실용적 loss를 제공함.
- 오른쪽 위: 1.8B parameter의 ViT-g에서도 heuristic 없이 안정적으로 학습되며 training loss가 안정적임.
- 왼쪽 아래: ImageNet-1K로 pretraining한 LeJEPA ViT-Large의 PCA feature에 명확한 semantic relationship이 나타남.
- 오른쪽 아래: Galaxy10의 in-domain 결과에서 LeJEPA의 in-domain pretraining은 1-shot부터 전체 supervision까지의 data regime에 걸쳐 자연 이미지로 학습한 최첨단 foundation model인 DINOv2/v3의 transfer learning보다 일관되게 높은 성능을 보임.
- 이는 framework가 어떤 domain·model·data scale에도 손쉽게 확장될 때, domain-specific SSL이 대규모 최첨단 모델을 이용한 generic transfer learning도 능가함을 보여줌.
- fθ에 의한 mapping을 나타냄.
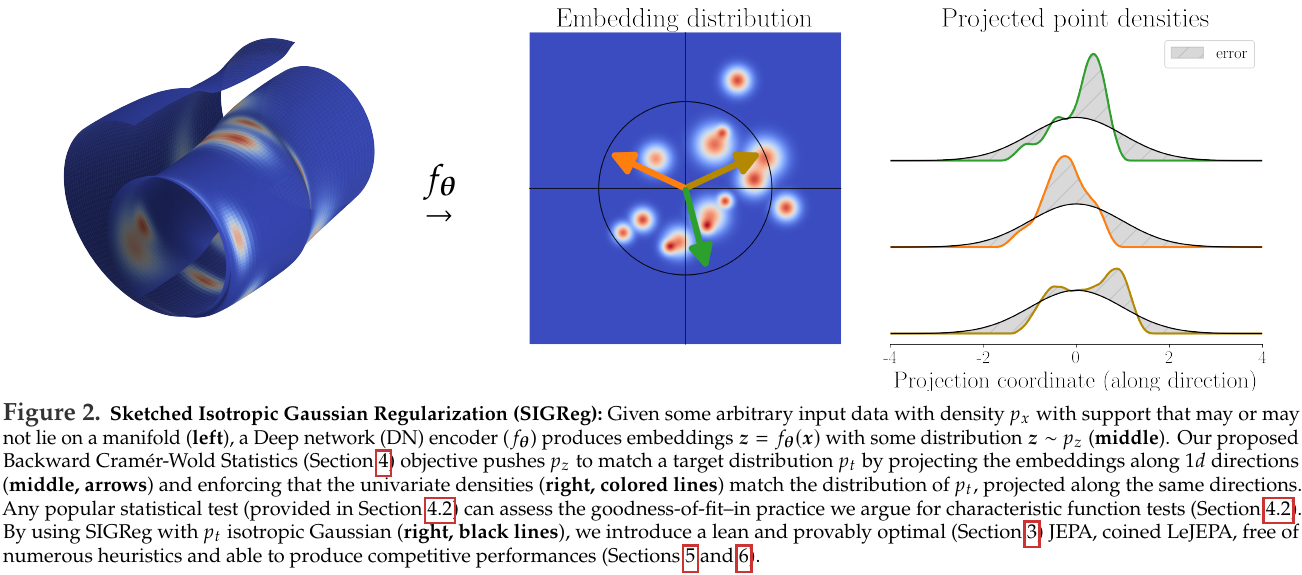
- Figure 2. Sketched Isotropic Gaussian Regularization(SIGReg)임.
- support가 manifold 위에 놓일 수도, 그렇지 않을 수도 있는 density px의 임의 input data가 주어지면(왼쪽), Deep Network(DN) encoder fθ가 어떤 분포 z∼pz를 따르는 embedding z=fθ(x)를 생성함(가운데).
- 제안한 Backward Cramér–Wold Statistics objective(Section 4)는 embedding을 1D 방향으로 projection하고(가운데 화살표), 그 univariate density(오른쪽 색 선)가 target distribution pt를 동일한 방향으로 projection한 분포와 일치하도록 하여 pz를 pt에 맞춤.
- 통상적인 statistical test(Section 4.2)로 goodness-of-fit을 평가할 수 있으며, 실제로는 characteristic function test의 사용을 주장함(Section 4.2).
- isotropic Gaussian pt를 대상으로 SIGReg를 사용하면(오른쪽 검정 선), 여러 heuristic이 필요 없고 경쟁력 있는 성능을 내는(Sections 5, 6) 간결하며 최적성이 증명된(Section 3) JEPA인 LeJEPA를 얻음.
1 Introduction
- 세계와 그 dynamics의 조작 가능한 representation을 학습하는 것은 수 세기 전까지 뿌리를 거슬러 올라가는 AI의 오랜 문제임(Von Helmholtz, 1867; Tolman, 1948; Gregory, 1980; Sutton, 1991; Friston, 2010).
- Image recognition·robotics·physics·space exploration 등 여러 domain을 관통하는 질문은 observation으로부터 체계적이고 행동에 활용 가능한 high-dimensional embedding space를 어떻게 학습할 것인가임.
- parameterized nonlinear operator인 Deep Network fθ로 observation을 embedding에 mapping하는 것은 이 퍼즐의 표준적인 첫 조각임(LeCun et al., 2015; Goodfellow et al., 2016).
- 덜 표준화된 두 번째 조각은 fθ를 어떻게 학습할 것인가임.
- Joint-Embedding Predictive Architectures(JEPAs)는 의미적으로 연관된 view들의 embedding 사이 predictive agreement를 최대화하여 fθ를 학습하도록 제안함(Bromley et al., 1993; LeCun, 2022; Balestriero et al., 2023).
- view는 transformation 또는 corruption의 두 형태로 얻을 수 있음.
- Masking·cropping·blurring·시간/공간 translation·기하/광도 transformation·viewpoint 변화·서로 다른 sensor modality의 view 등이 포함될 수 있음.
- supervised 형태에는 image–caption pair, text–code pair 등 사람이 생성한 구성 요소가 들어감(Tian et al., 2020).
- 어느 경우든 prediction task가 fθ의 embedding을 data에 내재된 지식 쪽으로 정렬할 수 있도록 view들이 일정한 semantic relationship을 공유한다고 기대함.
- 그러나 JEPA의 prediction task에는 fθ가 모든 input을 거의 동일한 embedding으로 mapping하는 complete collapse 또는 low-dimensional subspace로 mapping하는 dimensional collapse 등 representation collapse라는 실패 방식이 존재함(Jing et al., 2021; Jing et al., 2021; Cosentino et al., 2022; Balestriero and LeCun, 2022).
- 이런 shortcut solution을 줄이기 위해 최첨단 recipe는 stop-gradient(Chen et al., 2020a), 비대칭 view 생성(Wang et al., 2022), 세심하게 조정한 EMA schedule을 쓰는 teacher–student network(Caron et al., 2021; Tian et al., 2021), 명시적인 normalization·whitening layer(Ermolov et al., 2021; Chen et al., 2021)와 hyperparameter 사이의 정교한 균형에 의존함.
- 그 결과 오늘날 JEPA training은 취약하며, 이론적 기초를 대부분 탐구하지 않은 채 연구가 data scaling(Vo et al., 2024), model scaling(Fan et al., 2025), 심지어 post-training(Rodas et al., 2025)으로 이동했음.
Complete collapse와 dimensional collapse는 어떻게 다른가?
Collapse는 서로 다른 input을 구별하던 embedding 정보가 사라지는 현상임.
설명용 예로 고양이·자동차 사진을 모두 (1,1)로 보내면 complete collapse임. 두 coordinate가 항상 같아서 (a,a) 형태만 나오면 2D 공간을 쓴다고 해도 실질적으로 1D에 놓이는 dimensional collapse임.
View의 embedding을 같게 만드는 loss만 최소화하면 모든 sample을 같은 값으로 보내는 해가 너무 쉬움.
따라서 view 사이 일치는 유지하면서 서로 다른 sample의 분포가 충분히 퍼지도록 제약해야 하며, 논문은 이 역할을 SIGReg에 맡김.
- 본 연구는 JEPA를 뒷받침하는 근본적인 설계 원리 일부를 다시 질문하여 이 순환을 끊고자 함.
- 먼저 JEPA가 따라야 하는 필요조건은 무엇인지 질문함.
- 그 최소 조건을 새로운 간결한 JEPA를 설계하는 공리로 삼음.
- 두 공리는 (i) prediction task를 해결하면서 (ii) embedding에 isotropic Gaussian distribution을 강제하는 것임(Section 3).
- 조건 (i)는 표준적인 관행을 따르지만(Balestriero and LeCun, 2022), 조건 (ii)를 강제하기 위해 Section 4에서 새로운 distribution matching objective인 SIGReg를 도입함.
- SIGReg는 representation collapse를 막기 위해 쓰던 여러 heuristic을 없앨 뿐 아니라 memory·computational complexity가 dimension과 sample 수에 선형으로 증가하는 유리한 scaling 특성을 가짐.
- 특히 SIGReg의 isotropic Gaussian 강제는 collapsed shortcut solution을 해결하고, post-training 이후 만나게 될 downstream task 공간에 대한 model의 expected risk를 최소화함이 증명됨.
- 그 결과인 Latent-Euclidean JEPA(LeJEPA)를 Section 5에서 소개함.
- LeJEPA는 이론적 최적성 외에도 (i) 증명 가능한 statistical guarantee, (ii) teacher–student network 같은 heuristic 제거, (iii) 선형 memory·computational complexity, 특히 (iv) dataset·architecture·scale 전반에서 바로 작동하는 하나의 trade-off parameter를 가진 통일된 설계라는 이점이 있음(Section 6).
- 기여를 아래와 같이 정리함.
- Contribution 1: foundation model의 최적 embedding distribution을 증명함.
- 넓은 task family 전반에서 isotropic Gaussian이 downstream prediction risk를 유일하게 최소화함을 보임.
- Section 3에서 linear probe(Section 3.1)와 nonlinear probe(Section 3.2)에 대해 이 결과를 엄밀하게 유도하여, fθ의 embedding이 어떤 분포를 따라야 하는지에 대한 최초의 원칙적인 답을 제공함.
- 이 이론은 JEPA 설계를 heuristic 탐색에서 목표가 명확한 optimization으로 바꿈.
- Contribution 2: 증명 가능한 정확성과 대규모 computational efficiency를 함께 제공하는 distribution matching objective인 SIGReg를 도입함.
- Random projection과 characteristic-function matching으로 distributional alignment를 강제하는 새로운 objective인 SIGReg를 제시함(Sections 4, 2).
- SIGReg는 statistical guarantee(Sections 4.1, 4.2), linear complexity, bounded gradient를 함께 제공하며, 기존 distribution matching 방법은 이 조합을 제공하지 못함.
- 특히 projection 기반 구성이 curse of dimensionality를 극복하므로(Section 4.3), high-dimensional embedding에 이론적으로 타당하면서 실용적으로 효율적임.
- Contribution 3: 구조 자체로 collapse를 제거하는 statistically optimal JEPA를 설계함.
- JEPA predictive objective와 isotropic Gaussian을 target으로 하는 SIGReg를 결합하여 Latent-Euclidean JEPA인 LeJEPA를 도입함(Section 5).
- 하나의 hyperparameter만 필요하고, stop-gradient나 teacher–student architecture 없이 representation collapse를 없애며, hyperparameter tuning 없이 architecture와 dataset 사이에 적용됨.
- 이는 원칙에 근거한 이론이 곧바로 실용적인 단순성으로 이어짐을 보여줌.
- Contribution 4: 다양한 architecture에서 대규모로 LeJEPA를 검증하고 in-domain pretraining의 실현 가능성을 확립함.
- Section 6의 실험은 ViTs·ConvNeXts·ResNets·MaxViTs·Swin Transformers와 약 10억 parameter에 이르는 규모를 포괄하며, LeJEPA는 학습의 단순성·robustness를 유지하면서 최첨단 방법과 같거나 더 높은 성능을 보임.
- 특히 Galaxy10·Food101 같은 domain-specific dataset의 target data에 직접 pretraining하면 DINOv2 기반 transfer learning보다 높은 성능을 냄.
- 이는 transfer learning paradigm에 의문을 제기하며, 원칙적인 SSL로 이전에는 작은 dataset에서 비실용적이라 여겼던 효과적인 in-domain pretraining이 가능함을 보여줌.
2 Background and Notations
- 먼저 논문 전체에서 사용할 notation 일부를 소개하고(Section 2.1), JEPA(Section 2.2)와 그 설계를 연구하는 기존 문헌(Section 2.3)을 검토함.
2.1 Notations and Definitions
- Definition 1: JEPA의 정의임.
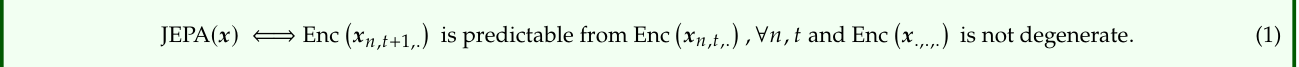
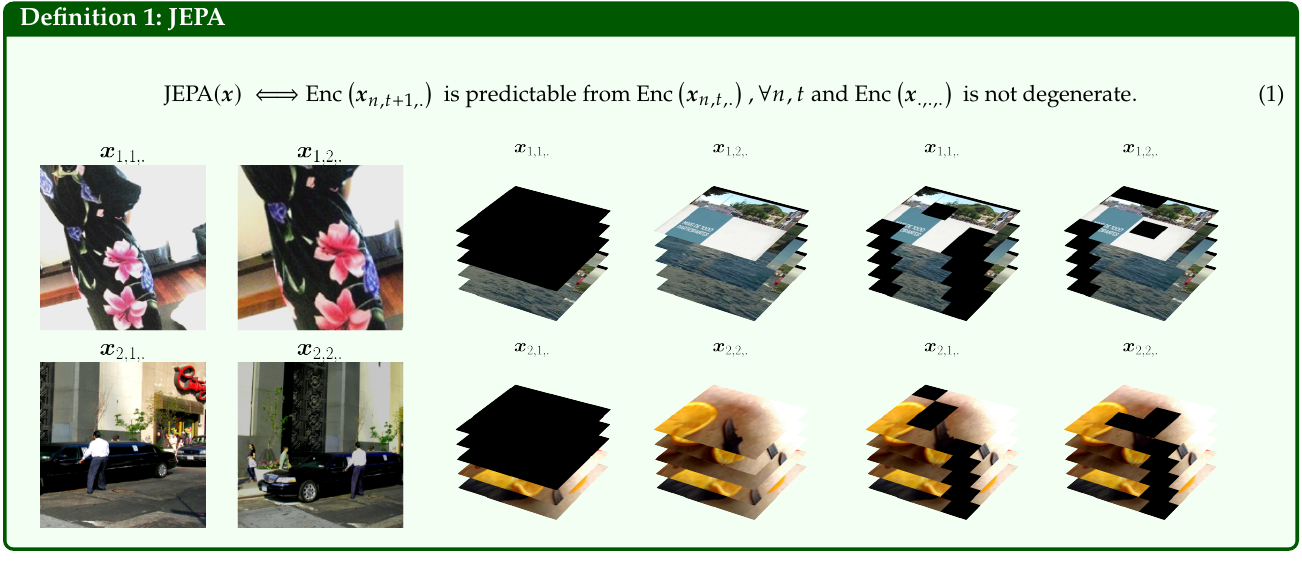
Equation 1의 의미는 모든 n,t에서 현재 view의 encoder output으로 다음 view의 encoder output을 예측할 수 있고, 전체 view의 encoder output이 degenerate하지 않아야 JEPA라는 것임.
Data.
- (N,V,D)∈(ℕ*)3 형태의 dataset이 있으며, N은 sample 수, V는 view 수, D는 dimension임.
- 이 dataset의 한 원소는 xn,v,d로 접근함.
- 보통 N은 서로 다른 image·video 등 독립적인 sample 수, V는 image의 data augmentation·video의 frame 같은 view 수, D는 image의 RGB pixel 수처럼 각 xn,v의 dimension으로 해석함.
- 많은 경우 V의 순서는 시간이 결정하지만, image data augmentation 같은 경우에는 순서가 무관함.
- 본 연구는 dataset을 (N,V,D) tensor로 구성하는 특별한 선택을 요구하지 않으며, 이론과 구현도 그 tensor의 특정 설계 결정을 가정하지 않음.
- 다만 두 성질에 의존함: independence는 모든 n≠n′에 대해 sample xn,xn′를 서로 독립적으로 얻었음을, identically distributed는 모든 xn에 같은 sampling process를 적용했음을 의미함.
(N,V,D) tensor에서 sample과 view를 왜 구별하는가?
Sample은 독립적으로 얻은 원래 observation이고, view는 한 sample에서 얻은 서로 연관된 관측임.
설명용으로 사진 32장마다 crop 4개를 만들고 crop마다 pixel 값 3072개를 펼치면 shape은 (32,4,3072)임.
Encoder를 통과한 embedding은 마지막 dimension만 K로 바뀌어 (32,4,K)가 됨.
같은 n의 view는 의미적으로 연관되어 prediction loss로 연결하고, 서로 다른 n에 걸친 분포는 SIGReg로 맞춤.
동일 사진의 crop 네 개를 독립 sample 네 개라고 잘못 세면 논문이 가정한 sample independence와 다른 문제를 만들게 됨.
Deep Networks.
- 오늘날 AI는 parameterized linear·nonlinear operator를 여러 층으로 합성한 Deep (Neural) Network(DN)에 의존함.
- DN mapping을 fθ:ℝD→ℝK로 표기하며, K는 embedding space의 dimension임.
- 연구자는 data에 대한 prior knowledge를 가능한 한 많이 포함하도록 fθ 내부를 설계함.
- 제안한 LeJEPA가 어떤 fθ에도 바로 작동함을 보게 되므로 그 내부 세부 사항은 본 연구와 무관함.
- 어느 경우든 모든 learnable parameter를 θ∈ℝP에 모으며, P는 전체 parameter 수임.
- 적절한 architecture와 training objective를 설계하여 gradient descent로 θ를 학습하고, 최종적으로 유용한 system 또는 foundation model fθ를 만드는 것이 AI 연구의 핵심 과제임.
JEPAs.
- Foundation model은 내부 parameter θ를 바꾸지 않고도 여러 downstream task를 해결할 수 있는 DN 등의 system임.
- 이는 training task만 고려하는 supervised model과 뚜렷하게 대비됨.
- LeCun(2022)은 foundation model을 만드는 수단으로 JEPA를 정식으로 제안했음.
- JEPA의 핵심 구성 요소는 siamese network(Bromley et al., 1993), predictive coding(Helmholtz and others, 1867; Bruner and Postman, 1949) 등 오래 확립된 기법에 기반함.
- 구체적인 설계는 use case마다 크게 다르지만, 모든 JEPA는 (i) 한 view xn,v′의 embedding으로 다른 view xn,v의 embedding을 예측하면서(v′≠v), (ii) embedding이 degenerate해지지 않도록 한다는 두 원리에 의존함.
- 즉 설계·학습을 마친 JEPA는 zero-shot 또는 few-shot으로 여러 downstream task를 해결할 수 있어야 함.
- JEPA objective와 x의 예를 Equation 1에 제시함.
- Predictability criterion은 partial view의 embedding Enc(xn,v,.), Enc(xn,v′,.)를 ℓp 등의 metric으로 직접 비교하여 구현할 수 있음.
- 때로는 Pred라는 추가 DN으로 Pred(Enc(xn,v,.))와 Enc(xn,v′,.)를 비교하지만, 이는 robotics data의 관측 action에 prediction을 conditioning하는 경우처럼 view 간 정보량에 비대칭이 있을 때만 정당화됨(Khazatsky et al., 2024).
언제 predictor가 필요하고, 언제 단순 일치만으로 충분한가?
Predictor는 한 embedding에서 다른 embedding을 계산하는 별도의 mapping임.
설명용으로 같은 사진의 두 crop은 대등한 observation이지만, 현재 frame과 action으로 미래 frame을 예측할 때는 action·시간의 방향성이 있음.
후자의 경우 encoder output에 action을 conditioning한 predictor가 정보를 전달하는 자연스러운 역할을 가짐.
이 논문이 image의 대칭 view 설정에서 predictor를 제거한다는 주장을, action-conditioned world model의 predictor까지 불필요하다는 주장으로 확장하면 안 됨.
2.2 The Need for Reliable Pretraining
- JEPA prediction task는 data에 대한 prior knowledge를 바탕으로 설계됨.
- 포착하려는 관련 정보를 view들이 공유하도록 x를 구성하는 것이 비교적 직관적이므로 그 설계는 흔히 자연스러움.
- 반면 anti-collapse criterion의 설계는 두더지 잡기에 더 가까움.
- 현재의 설계는 학습 중 degenerate shortcut solution을 피할 수 있기를 바라며, 명세가 불충분한 여러 safeguard를 세심하게 결합함.
- 그 장치에는 (i) feature whitening(Ermolov et al., 2021; Bardes et al., 2021), (ii) negative sample(Chen et al., 2020a; He et al., 2020), (iii) 비대칭 view와 stop-gradient를 쓰는 teacher–student network(Caron et al., 2021; Assran et al., 2023)가 포함됨.
- 이 장치들은 적어도 두 가지 한계를 가짐: (i) embedding이 degenerate한데도 criterion을 최소화할 수 있는 under-specification, (ii) minibatch 크기 또는 embedding dimension에 대한 이차 time·memory complexity, (iii) data distribution·hyperparameter·architecture 민감성, (iv) 이론적 이해와 guarantee의 부족임.
2.3 The Need for Actionable Theory
- 수십 년 동안 AI의 두 주요 해법은 supervised learning(LeCun et al., 2015)과 reconstruction을 통한 학습(Rumelhart et al., 1986)이었으며, semi-supervised learning처럼 둘을 결합하기도 했음(Kingma et al., 2014).
- Supervised learning에서 label은 의미적으로 유사한 sample을 embedding space에서 가깝게 만들면서 complete representation collapse도 막음.
- 특히 supervised learning의 collapse 정도를 class 수의 함수로 측정할 수 있음(Papyan et al., 2020).
- Reconstruction objective도 embedding에서 원래 input을 복원해야 하므로 representation collapse 방지에 적합함.
- 즉 사용자가 학습 과정에 추가할 수 있는 선택적인 denoising task를 제외하면 embedding은 input에 대한 정보를 최대한 유지해야 함(Vincent et al., 2010).
- Supervised·reconstruction-based learning은 수십 년간 폭넓게 연구되어, 실용적 설계를 설명하고 안내하며 foundation model 생성의 한계도 연구하는 방대한 문헌이 존재함(Balestriero and LeCun, 2024; Van Assel et al., 2025).
- 더 최근에 등장한 JEPA에서는 내부 작동을 이해하려는 시도보다 empirical advance가 빠르게 앞서므로 상황이 다름.
- 이 역학은 이미 발견된 해법을 사후에 이론적으로 정당화하는 방향으로 커뮤니티를 이끌었음(Liu et al., 2021; Shwartz Ziv and LeCun, 2024; Shwartz-Ziv et al., 2022; Zhang et al., 2023).
- 대부분의 연구는 Mutual Information(MI)(Shannon, 1948; Cover, 1999)을 다루며, 서로 다른 bound에서 기존 방법을 복원함(Gutmann and Hyvärinen, 2010; Ma and Collins, 2018; Oord et al., 2018; Poole et al., 2019; Hjelm et al., 2018; McAllester and Stratos, 2020).
- 기존 연구가 이미 개발된 JEPA의 설명·해석에 집중하여 원칙적인 지침과 혁신은 너무 적게 제시되었음.
- 대신 최근 empirical advance 대부분은 더 큰 dataset 수집, 기존 training recipe scaling(Goyal et al., 2019; Chen et al., 2020b; Oquab et al., 2023; Fan et al., 2025), 새로운 data curation process 도출의 형태임(Vo et al., 2024; Kerdreux et al., 2025).
- 반대로 이후 Sections 3, 4, 5의 목표는 first principle에서 새로운 JEPA 해법을 유도하는 것임.
- 즉 최적성의 증명된 필요조건에 근거해 설계하고, 탐색적 연구·scalability·최첨단 성능을 마침내 양립시키는 pretraining recipe를 얻고자 함.
3 Latent Euclidean: Embeddings Should be Isotropic Gaussian
- 어떤 downstream task에서도 empirical risk를 최소화하려면 Enc(x)가 어떤 분포를 따라야 하는가라는 근본적인 질문을 다룸.
- Linear probing(Section 3.1)과 nonlinear probing(Section 3.2) 모두에서 isotropic Gaussian이 유일한 최적 분포임을 증명하고, Section 3.3에서 geometric intuition을 제시함.
- 이 결과는 JEPA에 필요한 설계 원리를 확립하며, Section 4는 이를 달성할 실용적 구현을 제공함.
3.1 Linear Probing
- Frozen encoder를 평가하는 가장 널리 쓰이는 방법 중 하나인 linear probe를 분석하여 fθ embedding의 최적 분포를 먼저 찾음.
- 구체적으로 임의의 downstream task, 즉 target y의 어떤 realization을 해결하든 가장 유리한 fθ(x)의 분포가 무엇인지 질문함.
- fθ(xn)의 K-dimensional embedding N개를 모은 matrix를 Z∈ℝN×K로 표기함.
- 알려지지 않은 대응 label은 y∈ℝN로 표기함.
- 일반성을 잃지 않고 univariate target을 고려하며, 이후 분석은 multivariate target으로 확장됨.
- Linear probe는 다음 least-squares problem을 최소화함(Bishop and Nasrabadi, 2006).
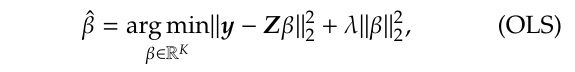
- 여기서 β̂는 최적 probe parameter이며, hyperparameter λ≥0는 Tikhonov regularizer의 강도를 조절함(Bishop, 1995; Golub et al., 1999).
- y를 모르더라도 estimator β̂의 bias·variance를 Z의 분포에 대한 함수로 기술할 수 있음.
- Column span이 같은 두 embedding Zaniso, Ziso를 고려함.
- Zaniso의 covariance eigenvalue는 적어도 두 값이 서로 다른 {λk}k=1K이며, Ziso의 covariance eigenvalue는 모두 (1)/(K)∑k=1Kλk와 같음.
- 따라서 두 후보는 같은 intrinsic feature를 포착하고 energy도 같지만 geometry가 다름.
Isotropic covariance가 linear probe에 왜 유리한가?
Isotropic은 모든 방향에서 covariance scale이 같은 상태임.
설명용으로 2D 점들이 원처럼 퍼지면 두 방향의 정보가 비슷하지만, 매우 가느다란 타원이라면 짧은 축의 변화를 관측하기 어려움.
OLS의 parameter variance에는 covariance eigenvalue의 역수 합이 들어가므로 아주 작은 eigenvalue가 noise를 크게 증폭함.
Ridge regularization은 작은-eigenvalue 방향을 상대적으로 더 강하게 축소하여, 그 방향에 정답이 놓인 task의 bias도 높일 수 있음.
이것이 논문이 energy와 column span을 맞춘 뒤 geometry를 비교하는 이유임.
- Lemma 1: Anisotropy가 bias를 증폭함.
- λK>λ1이면, λ>0일 때 Zaniso가 Ziso보다 bias가 큰 estimator를 만드는 downstream task y가 항상 존재함.
- 증명은 Section B.1에 있음.
- Lemma 2: Anisotropy가 variance를 증폭함.
- λ=0일 때 OLS의 β̂의 total variance는 Ziso에서 최소가 되며, tr(Var(β̂aniso))>tr(Var(β̂iso))임.
- 증명은 Section B.2에 있음.
- 위 Lemma 1·2의 결과에서 feature distribution이 isotropic이어야 함을 얻음.
- 이제 nonlinear probing으로 넘어가 standard Gaussian이 유일한 optimum으로 나타남을 보임.
3.2 Nonlinear Probing
- Pretrained encoder fθ를 더 유연하게 평가하기 위해 nonlinear probe의 사용이 점점 일반화되고 있음.
- 널리 쓰이는 두 nonlinear method를 분석함: 단순성이 장점인 radius-based k-NN(Taunk et al., 2019; Sun and Huang, 2010; Zhang et al., 2017; Abu Alfeilat et al., 2019)과 이론적으로 다루기 쉬운 kernel method(Nadaraya, 1964; Watson, 1964)임.
- Section 3.1처럼 foundation model에 어떤 embedding distribution이 더 유리한지 질문함.
- 먼저 prediction function을 정의함.
- Training data는 N개의 embedding과 training label {(zn,yn)}n=1N로 구성됨.
- Query vector q의 radius-based k-NN prediction은 다음과 같음.
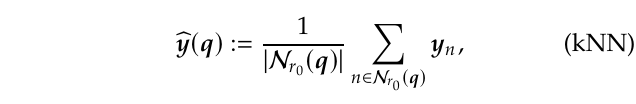
- 여기서 𝒩r0(q)={n:‖zn−q‖≤r0}임.
- Radius r0의 선택이 query prediction을 만들 때 몇 이웃의 prediction을 평균할지 조절함.
- Query q∈ℝK에서 kernel prediction은 다음과 같음.
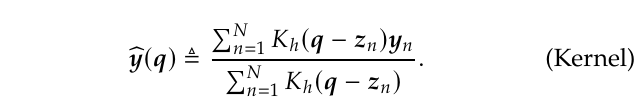
- 고정된 total variance constraint, 예를 들어 Tr(Cov(Z))=κ1 또는 ‖Cov(Z)‖F=κ2 아래에서 Z의 모든 분포를 탐색함.
- κ의 구체적 값은 최적 분포의 shape에 영향을 주지 않음.
- Linear regime과 같은 종류의 유도에 몇 가지 추가 regularity condition을 적용하여, 아래와 같이 bias를 최소화하는 유일한 optimum이 isotropic Gaussian임을 정확히 식별함.
- Theorem 1: isotropic Gaussian의 최적성임.
- Query point에 대한 integrated squared bias(ISB)는 다음과 같음.
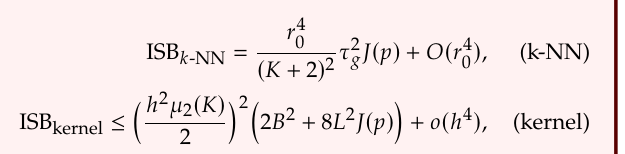
- Scalar-based covariance constraint를 만족하는 분포 중 isotropic Gaussian이 integrated squared bias를 유일하게 최소화함.
- 증명은 Sections B.4, B.7에 있음.
- 사용한 regularity assumption의 여러 추가 세부 사항과 논의는 Appendix A에 있음.
- 이 결과를 종합하면 isotropic Gaussian distribution은 여러 downstream task에 대한 foundation model의 worst-case risk를 최소화하는 최적 설계임.
‘Gaussian이 최적’이라는 결론에는 어떤 가정이 있는가?
논문의 최적성은 정해진 probe family와 target-function prior, smoothness, covariance constraint 아래의 bias·variance 또는 bound에 관한 결과임.
설명용으로 label이 특정 방향만 사용한다고 미리 알고 있다면, downstream task 정보가 전혀 없다는 상황과 목적이 달라짐.
Appendix A는 gradient의 isotropic prior, density의 regularity, kernel bandwidth의 극한 등을 명시함.
따라서 모든 현실 task와 임의의 nonlinear readout에서 Gaussian이면 무조건 최고라는 보편 명제로 읽지 않음.
핵심은 downstream task를 미리 알지 못할 때의 embedding 설계 원리를 이 분석에서 도출했다는 점임.
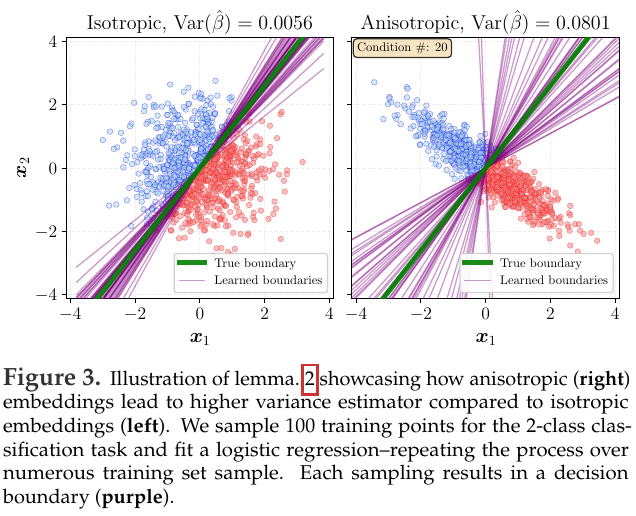
- Figure 3. Section 3.1을 시각화하여 anisotropic embedding(오른쪽)이 isotropic embedding(왼쪽)보다 variance가 큰 estimator를 만드는 모습을 보임.
- 2-class classification task에 training point 100개를 sample하고 logistic regression을 fitting하는 과정을 여러 training-set sample에 걸쳐 반복함.
- 각 sampling은 하나의 decision boundary(보라색)를 만듦.
3.3 Geometric and Practical Insights
- Downstream task에 대한 정보가 없을 때 isotropic Gaussian이 최적임을 실증 검증함.
- 고려하는 모든 분포의 total variance가 같은 linear probing에 집중함(Section 3.1).
- Linear probe에서 anisotropic distribution은 Tikhonov regularization이 있을 때 bias를 증가시키고 variance도 증가시킴.
- 먼저 bias(Lemma 1)를 살펴보기 위해 Figure 18에 continuous regression·discrete classification task의 시각화를 제시함.
- 추정 parameter와 ground-truth parameter 사이 cosine similarity는 isotropic distribution일 때만 1이며, anisotropic한 경우 sample 수나 regularization 강도와 관계없이 낮아짐.
- Variance(Lemma 2)에 관해서는, OLS 대신 logistic regression을 사용하더라도 covariance가 anisotropic인 오른쪽에서 isotropic인 왼쪽보다 training set 간 learned parameter의 변화가 훨씬 큼을 Figure 3에 보임.
- Figure 17은 두 경우 서로 다른 training sample에서 학습한 β parameter의 분포를 보여 이 효과를 추가로 설명함.
- Anisotropic distribution은 명확히 더 높은 variance의 estimator를 만듦.
- 이론과 실증 결과는 LeJEPA의 설계 원리를 확립함: post-training 이후 만나는 downstream task 전반의 worst-case risk를 최소화하려면 embedding fθ(x)가 isotropic Gaussian distribution을 따라야 함.
- Section 4에서 이 분포를 달성할 새 regularizer를 도입함.
4 SIGReg: Reliable Isotropic Gaussian Regularization in High-Dimension
- Section 3에서 isotropic Gaussian이 최적 embedding distribution임을 보였으므로, (i) differentiable, (ii) scalable, (iii) provable, (iv) interpretable한 distribution matching objective인 SIGReg를 제안함.
- SIGReg는 세 혁신에 기반함.
- 첫째, null hypothesis Pθ=Q 아래의 statistical test로 distribution matching을 정식화함(Section 4.1).
- 둘째, linear complexity와 효율적인 multi-GPU scaling을 유지하면서 bounded gradient·curvature를 보장하는 test를 찾음(Section 4.2).
- 셋째, SIGReg는 curse of dimensionality를 우회하여 collapsed shortcut solution을 완전히 제거함(Section 4.3).
4.1 Hypothesis Testing as a Judge
- fθ(x)의 분포 Pθ를 target distribution Q에 맞추기 위해서는 보통 여러 distance·divergence measure를 만들고 high dimension에서 추정함.
- 본 연구는 statistics에 근거한 다른 출발점을 제안함.
- 다음 hypothesis-testing framework를 고려함(Fisher, 1928; Neyman and Pearson, 1933).
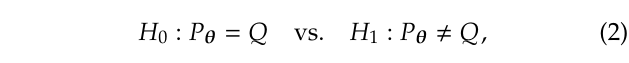
- H0를 null hypothesis라 부름.
- 즉 Equation 2는 null을 기각할 충분한 empirical evidence가 있는지 질문함.
- 이를 위해 (i) empirical sample의 증거를 하나의 scalar로 요약하는 test statistic을 사용하고, (ii) 참인 null을 잘못 기각하는 Type I error의 확률 α에 따라 critical value τα를 정하며, (iii) test statistic과 τα를 비교하여 statistic이 threshold를 넘으면 null을 기각함.
- Null을 기각하지 못했다면 Pθ=Q에 반하는 empirical evidence가 충분하지 않다는 것만 주장할 수 있음.
Null을 기각하지 못하면 두 분포가 같다는 뜻인가?
Hypothesis test는 제한된 sample이 null에 반하는 증거를 제공하는지 평가함.
설명용으로 적은 수의 동전 던지기에서 앞면 비율이 50% 근처라고 해서 동전이 완벽히 공정하다고 증명한 것은 아님.
Type I error는 참인 null을 잘못 기각하는 경우이고, power는 실제 차이가 있을 때 이를 발견할 능력임.
논문이 loss를 줄이는 방향으로 test statistic을 사용하더라도, 유한한 sample·direction에서 작은 loss가 분포의 완전한 동일성을 증명하는 것은 아님.
Consistency와 방향 수의 조건을 별도로 분석하는 이유임.
- 기존 test의 complexity는 고려하는 sample 수에 대해 적어도 quadratic이므로 Equation 2는 그대로는 high dimension에서 비실용적임(Appendix F의 상세 참조).
- 따라서 Equation 2를 더 단순한 univariate test로 분해하는 sketching strategy를 유도함.
- Push-forward distribution을 Pθ(a)≜(a⊤)#Pθ, Q(a)≜(a⊤)#Q로 표기하면 다음 directional univariate test를 정의할 수 있음.
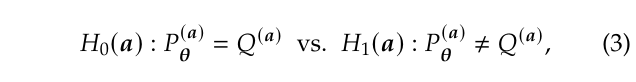
- 주어진 unit-norm direction vector a∈𝒮K−1에 대한 식임.
- Equation 3의 directional test statistic은 T({a⊤fθ(xn)}n=1N)로 계산함.
- Test T의 예는 이후 Section 4.2에 제시함.
- M개 방향의 집합 𝔸≜{a1,…,aM}에 대해 반복하고 각 값을 합치면 다음 global test statistic을 얻음.
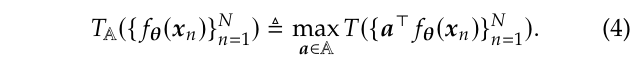
- Equation 4가 Equation 2의 원래 multivariate null hypothesis를 검정할 때 consistent함을 주장하는 formal statement를 제시함.
- 잘 알려진 union–intersection principle(Roy, 1953)과 약간 수정한 Cramér–Wold theorem을 이용함.
- d=는 equality in distribution을 뜻함.
- Lemma 3: Hyperspherical Cramér–Wold임.
- X,Y가 ℝd-valued random vector이면 다음이 성립함.
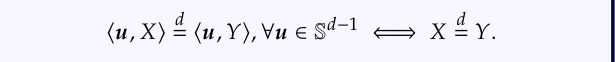
- Convergence in distribution도 성립함.
- 증명은 Section B.8에 있음.
고차원 분포를 1D projection으로 어떻게 알아보는가?
Cramér–Wold theorem은 모든 방향의 1D projection distribution이 같으면 원래 joint distribution도 같다는 결과임.
설명용으로 입체 물체를 한 방향의 그림자로만 보면 다른 물체와 구별하지 못할 수 있지만, 방향을 충분히 바꾸면 차이가 드러남.
실제 SIGReg는 embedding Z에 방향 matrix A를 곱해 N×M개의 projected value를 얻음.
Coordinate별 marginal만 맞추면 X 모양 같은 dependency를 놓칠 수 있으므로 random direction이 필요함.
모든 방향을 보는 정리와 finite M을 쓰는 구현의 차이는 Section 4.3에서 따로 다룸.
- Theorem 2: Directional test의 충분성임.
- Equation 4는 다음 의미에서 Equation 3의 유효한 statistical test임.
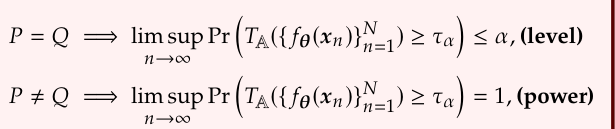
- 증명은 Section B.9에 있음.
- Theorem 2의 증명에 필요한 가정은 이후 Section 4.2에 제시하는 test처럼 classical consistent univariate test T에 대해 성립함.
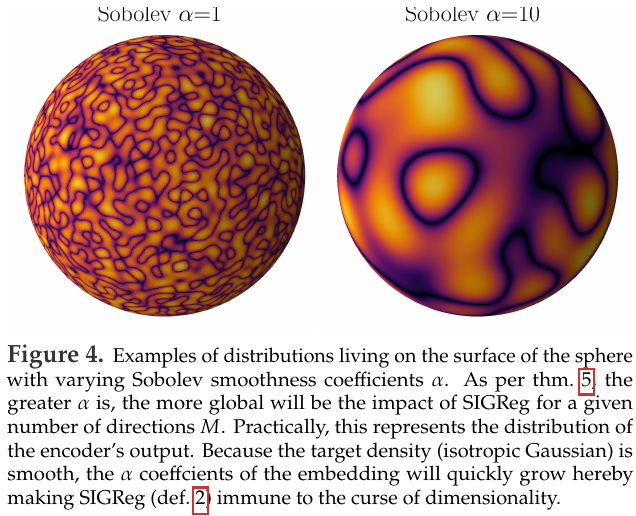
- Figure 4. Sobolev smoothness coefficient α를 달리하는, sphere surface 위의 분포 예시임.
- Section 4.3에 따라 α가 클수록 주어진 방향 수 M에서 SIGReg의 영향이 더 global해짐.
- 실제로 이는 encoder output의 분포를 나타냄.
- Target density인 isotropic Gaussian이 smooth하므로 embedding의 α coefficient가 빠르게 커져 SIGReg(Section 4.2)가 curse of dimensionality의 영향을 받지 않게 됨.
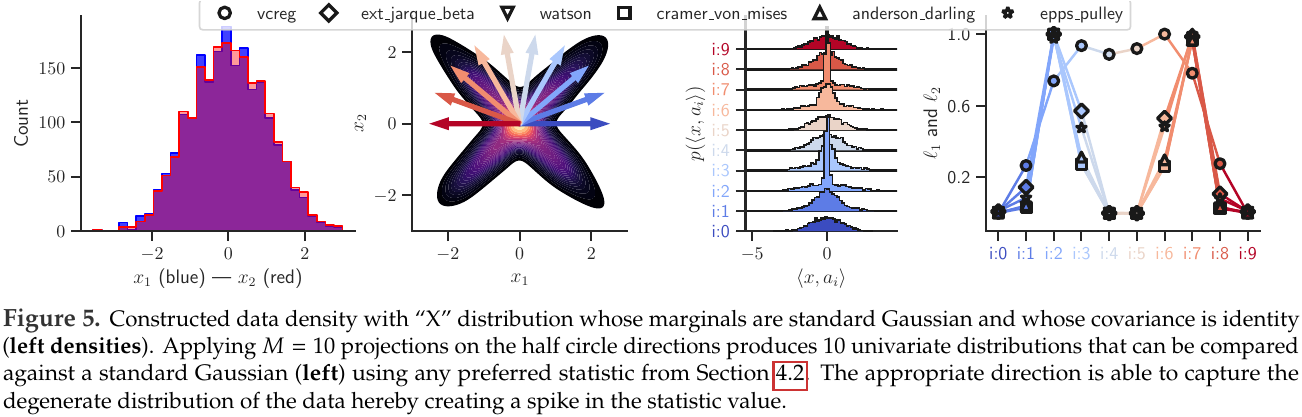
- Figure 5. Marginal이 standard Gaussian이고 covariance가 identity인데도 X 모양인 data density를 구성함(왼쪽 density).
- 반원 위 방향에 M=10개의 projection을 적용하면 10개 univariate distribution을 얻으며, 이를 Section 4.2의 원하는 statistic으로 standard Gaussian과 비교할 수 있음(왼쪽).
- 적절한 방향은 data distribution의 degenerate함을 포착하여 statistic value에 spike를 생성함.
4.2 SIGReg: Sketching the Epps-Pulley Test is Stable and Scalable
- 제안한 regularizer인 SIGReg는 isotropic Gaussian을 대상으로 하는 임의의 statistical test T를 Theorem 2에 적용하면 바로 얻어짐.
- Figures 2, 5에 시각화하고 아래와 같이 정식화함.
- Definition 2: SIGReg의 정의임(Algorithm 1의 PyTorch code 참조).
- SIGReg는 다음과 같이 isotropic Gaussian을 대상으로 statistical test T를 sketching함.
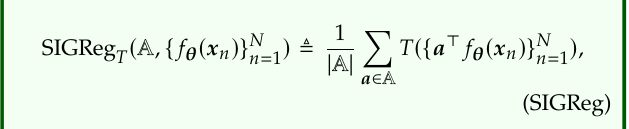
- T에는 Epps–Pulley test(Section 4.2.3)의 사용을 권장함.
- 𝔸의 방향 중 일부에만 gradient가 생기는 것을 피하기 위해 Theorem 2의 방향별 maximum을 Equation SIGReg에서 average로 대체함.
- 이제 statistics에서 잘 알려진 후보를 (i) moment-based(Section 4.2.1), (ii) CDF-based(Section 4.2.2), (iii) CF-based(Section 4.2.3)로 구분하여 비교하고, 궁극적으로 Epps–Pulley statistic의 선택을 정당화함.
4.2.1 Moments are Unstable and Insufficient
- 먼저 moment-based statistic 계열을 고려함.
- Standard Gaussian의 moment를 기준으로 third·fourth moment인 skewness·kurtosis를 비교하는 Jarque–Bera test(Jarque and Bera, 1980)를 다음처럼 정의할 수 있음.
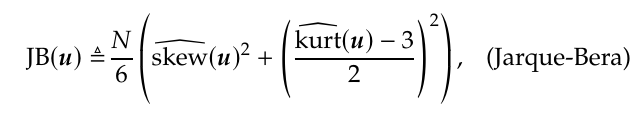
- 여기서 hat(skew)는 data에서 ((1)/(n)∑i=1n(xi−μ̂)3)/(σ̂3)으로 계산한 skewness이며, hat(kurt)=((1)/(n)∑i=1n(xi−μ̂)4)/(σ̂4)는 kurtosis임.
- 보통 Jarque–Bera test는 mean·variance가 임의인 Gaussian distribution인지 검정하므로 moment 3, 4만 봄.
- 여기서는 standard Gaussian을 검정하려 하므로 first·second moment에 대한 통상적인 statistic도 추가하여 다음 extended test를 얻음.
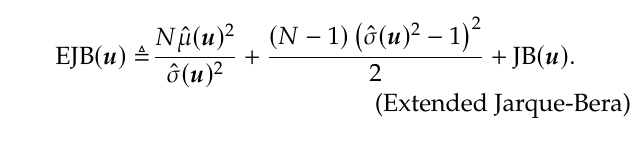
- Extended Jarque–Bera는 처음 네 moment를 맞추는 문제로 작동함.
- 이런 moment-matching 방법은 statistical test뿐 아니라 parametric·nonparametric data model을 학습하는 데에도 강력함이 입증되었음.
- Stability와 identifiability의 난제임.
- Moment-based test가 강력하지만 LeJEPA에 적합하지 않은 이유를 설명함.
- 분포 P의 k번째 moment를 mk(P)로 표기함.
- Gaussian처럼 Carleman condition ∑k=1∞m2k(Q)−1/(2k)=∞를 따르는 well-behaved distribution(Carleman, 1926) 또는 finite interval의 분포(Hausdorff, 1923)는 모든 moment에 의해 유일하게 결정됨.
- 하지만 유한한 수의 moment만 사용하면 다음 non-identifiability 문제가 생기며, 이는 statistics에서 잘 알려져 있고 모든 moment를 사용해야 하는 동기로 자주 쓰임(Lehmann and Romano, 2005).
- Theorem 3: K개 moment만으로는 충분하지 않음.
- 모든 k에서 ck>0일 때 다음 objective를 최소화하더라도,
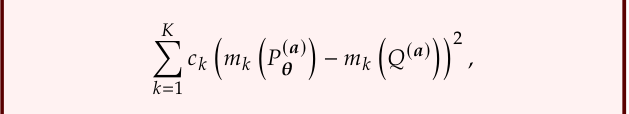
- 유한한 K에 대해서는 Pθ(a)=Q(a)가 보장되지 않음.
- 증명은 Section B.11에 있음.
- 따라서 Theorem 3은 정확한 distribution matching으로 collapsed shortcut solution을 없애려면 가능한 한 큰 K를 사용하라는 지침을 줌.
- 그러나 그렇게 하면 k번째 moment의 gradient norm이 O(k)로 scaling하고 Monte Carlo gradient estimate의 variance가 O(k2m2(k−1))로 증가하여 gradient-based training이 불안정해짐.
- 이는 ‖∇θmk(Pθ(a))‖=‖𝔼[k(a⊤fθ(x))k−1a⊤Jfθ(x)]‖이기 때문이며, Jfθ(x)∈ℝK×P는 Jacobian matrix임.
- 결국 training stability와 identifiability를 동시에 달성할 수 없는 비실용적인 상황이 생김.
Moment를 더 많이 맞추면 왜 불안정해질 수 있는가?
k번째 moment는 값의 k제곱에 대한 평균이므로 큰 관측값에 민감함.
설명용으로 값 3의 제곱은 9지만 10제곱은 59049이고, 그 derivative도 매우 커짐.
적은 moment만 맞추면 서로 다른 분포를 구별하지 못하고, 높은 moment까지 맞추면 gradient·sampling variance가 커질 수 있음.
SIGReg는 단순히 mean·variance만 정규화하는 방법과 달리 분포 전체를 구별하려 하면서도 안정적인 statistic이 필요하므로 CF 기반 접근을 선택함.
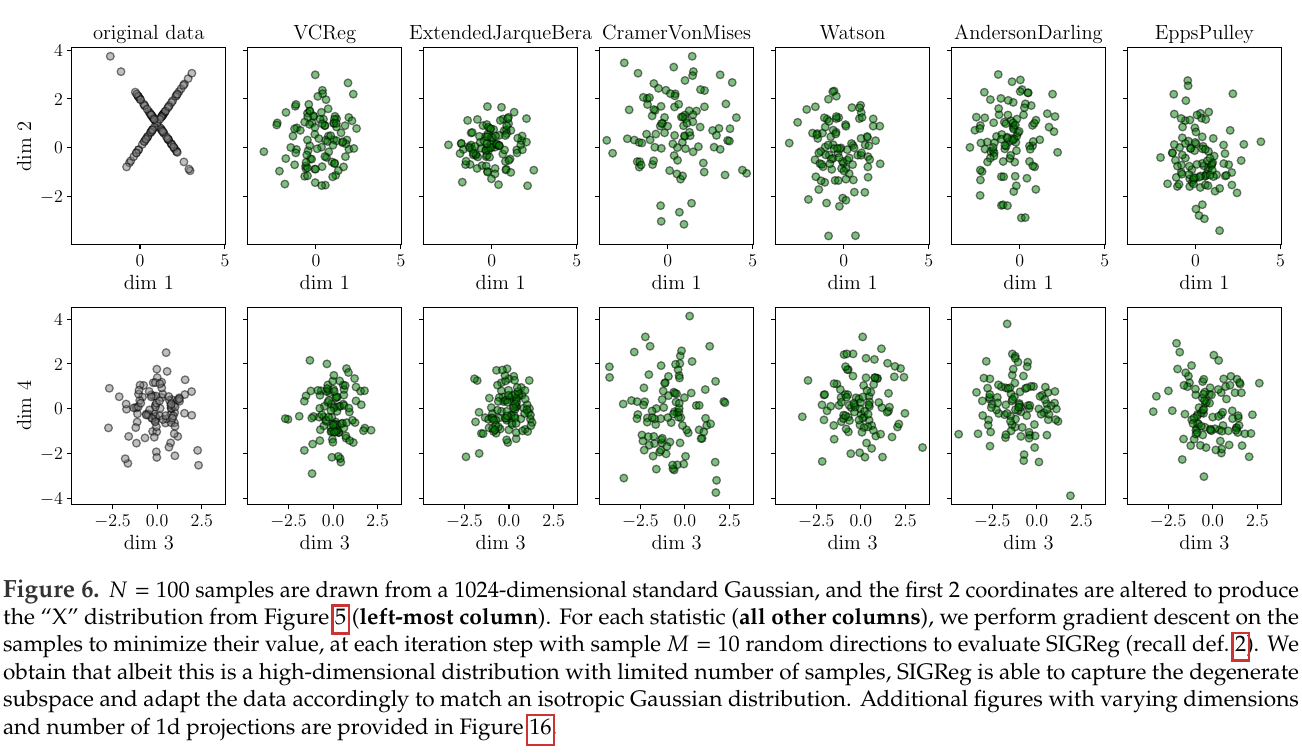
- Figure 6. 1024-dimensional standard Gaussian에서 N=100개 sample을 얻고 첫 두 coordinate를 Figure 5의 X distribution으로 바꿈(맨 왼쪽 열).
- 나머지 열의 각 statistic 값이 작아지도록 sample에 gradient descent를 수행하고, 각 iteration마다 M=10개 random direction을 sample하여 SIGReg를 평가함(Section 4.2).
- Sample이 적은 high-dimensional distribution인데도 SIGReg가 degenerate subspace를 포착하고 data를 조정하여 isotropic Gaussian distribution에 맞출 수 있음을 보임.
- Dimension과 1D projection 수를 바꾼 추가 그림은 Figure 16에 있음.
4.2.2 Cumulative Density Functions are Impractical
- 두 번째 test 계열은 CDF에 작용함.
- 이 test들은 sorting이 필요하므로 N개 sample의 k번째 order statistic을 xk:N으로 표기함.
- 서로 다른 weighting을 쓰는 quadratic Empirical Density Function statistic의 매우 표준적인 두 test는 Cramér–von Mises(Cramér, 1928; Von Mises, 1981)와 Anderson–Darling(Anderson and Darling, 1952)이며, 다음과 같음.
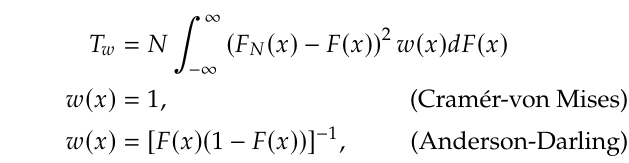
- 여기서 w(x)는 weighting function임.
- Cramér–von Mises 식에 U2 statistic을 추가하면 Watson test를 복원함(Watson, 1961).
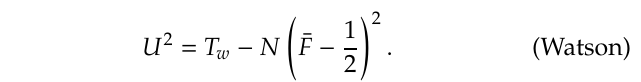
- Kolmogorov–Smirnov test(Kolmogorov, 1933)는 ℓ2 norm 대신 ℓ∞ norm을 써 sparse gradient를 만들므로 고려하지 않음.
- 다른 흔한 test인 Shapiro–Wilk(Shapiro and Wilk, 1965)는 실제로 불안정했으며, 세부 사항은 Appendix E에 제시함.
- Scalability와 differentiability가 부족함.
- CDF-based test는 𝒪(NlogN) Quicksort(Hoare, 1962)처럼 고도로 최적화된 sorting을 요구하지만, synchronization 때문에 특히 multi-GPU에서 SGD의 손쉬운 병렬성을 깨뜨림(Tanasic et al., 2013; Maltenberger et al., 2022).
- 또한 sorting·order statistic이라는 non-differentiable operation을 포함하여 relaxation 없이는 gradient-based optimization에 적합하지 않음(Cuturi et al., 2019; Grover et al., 2019; Petersen et al., 2022).
- 정교한 sketching solution이 존재하지만(Dunning and Ertl, 2019; Masson et al., 2019; Dunning, 2021), 각각 여러 추가 hyperparameter를 도입하므로 LeJEPA의 첫 동기에 어긋남.
Sorting이 multi-GPU 학습에서 왜 부담인가?
각 GPU가 sample 일부를 처리한 뒤 sum·average를 합치는 연산은 쉽게 병렬화됨.
반면 전체 sample의 순서를 알아야 하는 sorting은 GPU별 local 순서만으로 끝나지 않고 global communication·synchronization이 필요함.
CDF test의 통계적 유효성과 이를 매 training step의 differentiable loss로 쓰기 쉬운지는 별개임.
논문은 relaxation·sketching으로 해결할 가능성을 부정하지 않고, 추가 복잡성과 hyperparameter가 간단한 JEPA라는 목표에 맞지 않는다고 판단함.
4.2.3 Characteristic Functions are Stable, Scalable and Identifiable
- 세 번째 test 계열은 density function의 Fourier transform인 Empirical Characteristic Function(ECF)을 다룸.
- 가장 널리 쓰이는 test 중 하나인 Epps–Pulley(Epps and Pulley, 1983)는 data ECF와 target CF를 weighted ℓ2 norm으로 단순히 비교함.
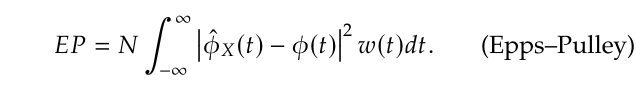
- 첫 번째 중요한 관찰은 ϕ̂X(t)=(1)/(n)∑j=1neitXj로 정의한 ECF가 complex exponential의 단순 average이므로 자연스럽게 differentiable하고 효율적인 all_reduce로 distributed setting에서도 쉽게 계산된다는 점임.
- Weight function은 보통 Gaussian, 예를 들어 w(t)=e−t2/σ2이며, σ는 흔히 1로 설정함.
Characteristic function은 무엇이고 복소수를 왜 쓰는가?
Characteristic function은 ϕ(t)=𝔼[eitX]이며, Euler identity로 𝔼[cos(tX)]+i𝔼[sin(tX)]로 나뉨.
설명용으로 각 sample을 t에 따라 회전하는 unit circle의 point로 바꾸고 그 평균을 구한다고 볼 수 있음.
실수·허수 성분은 항상 bounded하므로 큰 input을 높은 차수로 거듭제곱하는 moment와 다른 안정성을 가짐.
Standard normal의 CF는 e−t2/2이므로 target sample을 별도로 생성하지 않고 analytic target과 비교할 수 있음.
Training에서는 몇 t 값에서 ECF를 계산하고 weighted squared difference를 적분 근사함.
- Entropy 기반 test(Székely and Rizzo, 2005) 등은 univariate entropy estimation(Silverman, 2018; Beirlant et al., 1997)에 kernel(Joe, 1989) 또는 M-estimator(Miller, 2003) 사용과 같은 여러 추가 설계 선택이 필요하므로 여기서는 고려하지 않음.
- Epps–Pulley는 loss·gradient·curvature가 bounded함.
- 이제 남은 moment-based·CF-based 두 test 계열을 고려함.
- Moment는 data에 대한 polynomial이며, 존재한다고 가정해도 높은 moment는 극단적으로 빠르게 증가함.
- Well-behaved distribution에서도 값을 k제곱하면 gradient가 빠르게 폭발할 수 있음.
- 반면 ECF는 projected sample zi=a⊤fθ(xn), n=1,…,N의 input distribution에 관계없이 항상 bounded하며 gradient도 bounded함.
- Theorem 4: Epps–Pulley test의 안정성임.
- Sample z1,…,zN에 대해 Epps–Pulley는 다음을 만족함.
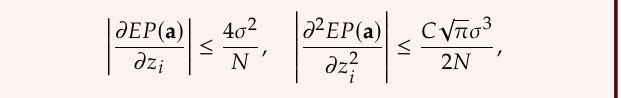
- C는 constant이며 σ는 bandwidth임.
- 증명은 Section B.12에 있음.
- Algorithm 1. Epps–Pulley statistic을 사용하는 SIGReg 구현으로 DDP를 지원하며 time·memory complexity가 𝒪(N)임.
- x는 (N,K) tensor이고, num_slices는 Definition 2의 |𝔸|이며, global_step은 GPU 간 sampling을 동기화하는 데 사용하고 single-GPU에서는 생략할 수 있음.
- 공식 codebase에는 caching을 적용한 최적화 구현도 있으며, computation time은 Table 6에 있음.
def SIGReg(x, global_step, num_slices=256):
    # slice sampling -- synced across devices --
    dev = dict(device=x.device)
    g = torch.Generator(**dev)
    g.manual_seed(global_step)
    proj_shape = (x.size(1), num_slices)
    A = torch.randn(proj_shape,  generator=g, **dev)
    A /= A.norm(p=2, dim=0)
    # -- Epps-Pulley stat. see Sec. 4.3 for alt. --
    # integration points
    t = torch.linspace(-5, 5, 17, **dev)
    # theoretical CF for N(0, 1) and Gauss. window
    exp_f = torch.exp(-0.5 * t**2)
    # empirical CF -- gathered across devices --
    x_t = (x @ A).unsqueeze(2) * t  # (N, M, T)
    ecf = (1j * x_t).exp().mean(0)
    ecf = all_reduce(ecf, op="AVG")
    # weighted L2 distance
    err = (ecf - exp_f).abs().square().mul(exp_f)
    N = x.size(0) * world_size
    T = torch.trapz(err, t, dim=1) * N
return T- 코드 주석 번역임: Slice sampling을 device 간 동기화함.
- Epps–Pulley statistic을 계산하며 대안은 Section 4.3을 참조함.
- Integration point를 설정함.
- 𝒩(0,1)의 theoretical CF와 Gaussian window를 계산함.
- Empirical CF를 device 간 gather함.
- Weighted ℓ2 distance를 계산함.
SIGReg 코드의 tensor shape과 distributed 계산은 어떻게 흐르는가?
Input x는 N×K이고 normalized direction A는 K×M임.
x@A는 N×M이며, T개 integration point를 곱하면 N×M×T가 됨.
Complex exponential을 sample 축으로 평균하여 M×T ECF를 얻고, GPU별 average를 all_reduce로 합침.
Target CF와의 차이를 T 축으로 적분하면 direction별 statistic M개가 남음.
따라서 이 코드의 SIGReg 반환값은 direction별 vector이며, 외부의 mean으로 scalar objective를 구성하는 문맥을 함께 확인해야 함.
M·T를 고정할 때 N에 선형이라는 말과, 전체 연산이 N·K·M·T에 무관하다는 말은 다름.
- Chain rule에 따라 Theorem 4에서 ‖∇θEP(a)‖≤(4σ2)/(N)∑i=1N‖a⊤∇θfθ(xi)‖를 직접 얻어 stable gradient를 보장함.
- Moment-based·CDF-based test의 한계와 Theorem 4를 종합하면 Epps–Pulley의 선택이 정당화됨: (i) DDP 친화성과 scalability, (ii) input distribution에 무관한 uniformly bounded gradient·curvature, (iii) hyperparameter-free 구현임.
- 마지막으로 minibatch 크기가 N일 때 구현의 memory·computational complexity가 𝒪(N)으로 선형임을 강조함.
- 이 test를 사용하는 SIGReg 구현은 위 코드에 있으며 forward–backward pass computation time은 Table 6에 제시함.
- LeJEPA를 소개하기 전 마지막으로, high dimension에서 SIGReg가 효과적으로 작동하려면 필요한 방향 수 |𝔸|를 연구해야 함.
4.3 How SIGReg Beats the Curse of Dimensionality
- 이 절에서는 Equation SIGReg가 효과적인 statistical test가 되려면 𝔸에서 몇 slice를 sample해야 하는지 규명함.
- 이 설계는 LeJEPA가 isotropic Gaussian embedding으로 성공적으로 수렴하기를 원한다면 중요함.
Smoothness Beats the Curse of Dimensionality
- Embedding dimension K에 대해 |𝔸|가 유리하게 scaling한다는 첫 논거는 Sobolev regularity α로 측정한 Pθ의 smoothness에 근거함(Adams and Fournier, 2003).
- |𝔸|=M개 방향에서 statistic을 최소화할 때 가능한 모든 방향 a에 대한 Equation 3의 directional test bound를 정식화함.
- 유한한 방향 집합에서 EP test가 0이 되는 경우 random direction a에 대한 expected discrepancy의 bound를 제시하지만, 증명에는 moment-based·CDF-based test도 포함됨.
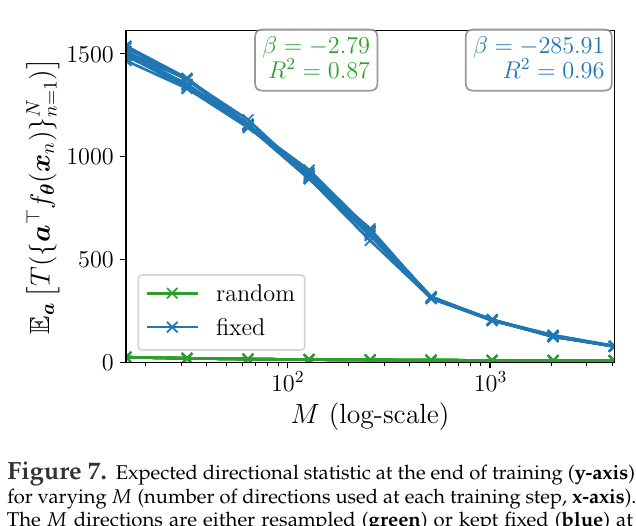
- Figure 7. 각 training step의 방향 수 M(x축)을 바꾸었을 때 학습 종료 후 expected directional statistic(y축)임.
- 각 step에서 M개 방향을 resampling한 경우는 초록색, 고정한 경우는 파란색임.
- 고정한 방향에서는 M을 늘리면 전체 expected loss가 감소하는 Section 4.3의 bound가 적용되지만, 매 step resampling하면 추가 비용 없이 coverage가 크게 향상됨.
- Theorem 5: Unified Error Bounds임.
- pθ∈Hα(ℝK), a∼𝒰(𝒮K−1)이며 Epps–Pulley가 0, 즉 모든 a∈𝔸에서 Pθ(a)=Q(a)이면 다음이 성립함.
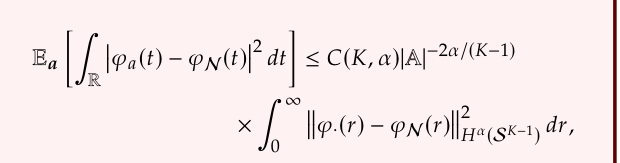
- 증명은 Section B.10에 있음.
- |𝔸|→∞이면 bound는 |𝔸|−2α/(K−1)로 감소하므로, α가 클 때 ϵ-approximation에 |𝔸|=O(K)개 방향이면 충분함.
- 서로 다른 α의 embedding density 예는 Figure 4에 제시함.
- 이 결과는 α에 따라 M개 방향이 실제로 전체 공간을 어떻게 제약하는지 규명함.
- 상수 C(K,α)=(22απ(K−1)/2Γ(α+(K−1)/(2)))/((K−1)Γ(α)Γ((K−1)/(2)))를 Figure 15 왼쪽에 시각화하여 α와 |𝔸|의 상호작용을 보임.
- 즉 architecture 또는 training 중의 implicit·explicit regularizer에서 비롯되는 DN의 자연스러운 smoothness 덕분에, |𝔸|개 방향에 적용한 SIGReg만으로 전체 공간을 강하게 제약할 수 있음.
- a에 대한 worst case를 고려하거나 low-discrepancy sequence를 사용해도 asymptotic bound는 바뀌지 않으며, 세부 사항은 Appendix D에 있음.
Smoothness와 random resampling은 서로 어떤 역할을 하는가?
Smoothness는 가까운 direction에서 projected distribution이 얼마나 급격하게 변하는지 제약하는 정규성임.
설명용으로 sphere 위 값이 완만하게 변하면 제한된 관측점 사이의 값을 추론하기 쉽지만, 매우 좁은 spike가 많으면 어려움.
이론의 finite-direction bound는 smoothness와 direction coverage 조건에 의존함.
SGD에서는 매 step 새로운 direction을 뽑아 누적 coverage를 늘리므로, 한 번 뽑은 finite set을 고정하는 것보다 많은 부분을 탐색함.
논문이 dimension만 보고 언제나 적은 M이면 충분하다고 무조건 보장한 것으로 해석하지 않음.
SGD Beats the Curse of Dimensionality
- 두 번째 논거는 DN training의 iterative한 성격을 이용함.
- |𝔸|를 수백 개만 사용해도 누적 sampling direction 수는 training time에 선형으로 증가함.
- 이 resampling 효과(Figure 7 아래)는 빠른 수렴을 가능하게 함.
- 작은 |𝔸|로도 minibatch 전체에서 𝔸를 고정하는 경우보다 정밀한 distribution matching을 달성함(Theorem 5 참조).
- 실험에서는 매 minibatch resampling의 누적 효과 덕분에 |𝔸|=16 정도로 적어도 수천 개의 고정 방향 집합을 쉽게 능가함.
Empirical Validation on Synthetic Data
- 통제된 실험에서 Equation SIGReg와 gradient-based training으로 isotropic embedding을 만드는 것으로 이 절을 마침.
- Embedding Z 자체를 미분 가능한 변수로 두고 Equation SIGReg를 최소화하도록 직접 최적화함.
- 직접 최적화하므로 architecture에서 생길 constraint·regularization 없이 loss의 영향을 관찰할 수 있음.
- D-dimensional space에서 N개 i.i.d. sample xn을 sample함.
- Sampling은 isotropic Gaussian에 기반하지만 첫 두 dimension은 다시 adversarial X shape로 설정함.
- 즉 나머지는 이미 target isotropic Gaussian을 따르므로 D개 중 두 dimension만 변환하면 됨.
- Sample xn을 differentiable하게 만들고, M개 random direction에서 계산한 여러 statistical test 값을 최소화하도록 최적화함.
- LeJEPA에서 사용할 절차처럼 매 gradient step 후 방향을 resampling함.
- Figure 6은 D=512, M=16이라는 어려운 경우에도 SIGReg가 두 degenerate dimension을 찾아 target distribution에서 기대하는 모습으로 다시 펼칠 수 있음을 보임.
5 LeJEPA: Stable and Scalable Implementation
- Section 3에서 foundation model의 최적 embedding distribution이 isotropic Gaussian임을 확립하고, 이를 달성할 SIGReg를 도입했으므로(Definition 2), 이제 완전한 LeJEPA framework를 제시함.
- 먼저 후보 statistical test를 평가하고(Sections 4.2.1, 4.2.2) characteristic-function-based test가 gradient-based training에 최적임을 확인함(Section 4.2.3).
- 전체 LeJEPA 구현은 Section 5.1에 제시함.
5.1 LeJEPA: SIGReg + Prediction Loss
- Algorithm 2. LeJEPA 구현은 어떤 dataset, DDP, torchvision·timm 등의 backbone에도 바로 작동함.
- ViT가 아닌 ResNet 등의 architecture에서는 global_views = all_views로 설정함.
- bs는 minibatch 크기이며 SIGReg는 Algorithm 1의 구현을 사용함.
def LeJEPA(global_views, all_views, lambd):
    """global_views and all_views are lists of tensors, lambd is a scalar"""

    # embedding of global views
    g_emb = forward(torch.cat(glob_views))
    # embedding of local views
    # if resnet: skip with a_emb=g_emb
    a_emb = forward(torch.cat(all_views))

    # LeJEPA loss
    centers = g_emb.view(-1, bs, K).mean(0)
    a_emb = a_emb.view(-1, bs, K)
    sim = (centers - a_emb).square().mean()
    sigreg = mean(SIGReg(emb, global_step) for emb in a_emb)
return (1-lambd)*sim + lambd*sigreg- 코드 docstring·주석 번역임: global_views·all_views는 tensor의 list이며 lambd는 scalar임.
- Global view embedding을 계산함.
- Local view embedding을 계산함.
- ResNet이면 a_emb=g_emb로 두어 이 계산을 건너뜀.
- LeJEPA loss를 계산함.
논문의 짧은 코드를 그대로 실행해도 되는가?
위 code는 원문을 보존한 것이며 이름·주석을 임의로 고치지 않았음.
함수 argument는 global_views인데 첫 torch.cat에는 glob_views가 쓰여 있어, 둘을 연결하는 별도 정의가 없다면 Python에서 이름이 일치하지 않음.
또한 bs·K·forward·global_step·world_size·all_reduce·mean은 이 snippet 바깥의 training 문맥에 의존함.
따라서 이 짧은 블록을 독립적으로 실행 가능한 완성 program으로 취급하지 않고, 실제 재현에서는 함께 링크한 공식 codebase의 정의와 scalar reduction을 확인해야 함.
- SIGReg부터 prediction loss, total loss 순으로 LeJEPA 구현을 설명함.
The SIGReg Loss.
- 증명된 boundedness(Theorem 4)와 scalability 때문에 Epps–Pulley를 선택함.
- Integral을 quadrature approximation으로 추정한다는 점 외에는 수식 그대로 구현함.
- Figure 20의 ablation처럼 knot가 17개뿐이어도 단순한 trapezoidal quadrature rule이면 충분함.
- 특히 integrand의 symmetry로 비용 없이 knot 수를 두 배로 늘리며, 공식 code를 참조함.
- 한편 minibatch 사용은 𝒪(1/N)로 사라지는 bias를 도입하며, 다음과 같이 정식화함.
Trapezoidal quadrature는 무엇을 근사하는가?
Quadrature는 연속 함수의 integral을 유한한 평가점의 weighted sum으로 근사하는 방법임.
설명용으로 두 이웃 점의 함수값을 직선으로 연결하면 그 구간 면적은 trapezoid 넓이가 됨.
이 구현은 t의 finite interval에 grid를 놓고 ECF와 Gaussian CF 사이 오차를 평가한 뒤 torch.trapz로 합침.
Interval truncation·grid discretization은 deterministic approximation이고, finite minibatch로 ECF를 추정해서 생기는 bias는 별개임.
Theorem 6의 1/N bias를 grid point 수를 늘리는 것만으로 없앨 수는 없음.
- Theorem 6: Gradient bias가 소멸함.
- Epps–Pulley의 expectation은 다음을 만족함.
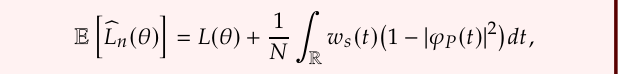
- 따라서 loss와 그 derivative 모두 O(1/n) 차수의 bias를 가짐.
- 증명은 Section B.13에 있음.
- 따라서 Epps–Pulley에서 얻는 gradient에는 명시적인 𝒪(1/N) bias term이 있음.
- 이 bias는 매우 작았고 minibatch가 16처럼 작아도 문제가 되지 않았음.
- Unbiased 대안에는 |ϕθ|2의 U-statistic debiasing이나 sample splitting이 있지만 이 연구에서는 탐구하지 않음.
- Epps–Pulley statistic을 사용하는 최종 SIGReg term 구현은 앞선 코드에 있음.
The Prediction Loss.
- 표기를 통일하기 위해 DINO(Caron et al., 2021)를 따라 Vg개 global view와 Vl개 local view를 생성하여 전체 V=Vg+Vl개의 view를 얻음.
- 각 zn,v의 처음 1,…,Vg index를 global view로 설정함.
- Local view가 없으면 Vl=0으로 설정하면 됨.
- 모든 view가 global view를 예측하도록 prediction loss를 다음과 같이 정의함.
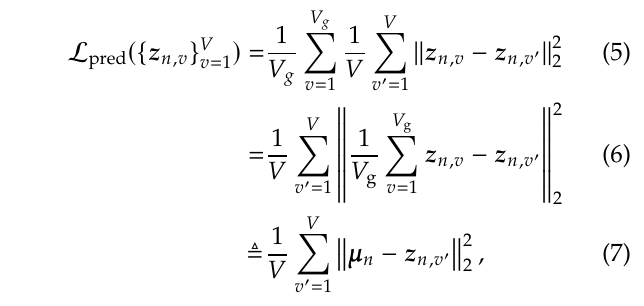
- 여기서 μn≜(1)/(Vg)∑v=1Vgzn,v로 표기하며, Equations 5→6의 유도는 Section B.6에 상세히 제시함.
원문의 prediction-loss 등호는 일반적으로 그대로 성립하는가?
이 부분은 원문과 별도로 점검한 수학적 보충임.
Global embedding의 평균을 μ라 하면, 모든 global–all-view pair의 squared distance 평균은 모든 view와 μ 사이 squared distance 평균에 (1)/(Vg)∑v‖zv−μ‖2를 더한 값임.
설명용으로 global view가 0과 2이고 비교 view가 1이면 pairwise 평균은 1이지만 center 1과의 squared distance는 0임.
따라서 PDF Equations 5→6의 등호는 일반적으로 추가 global-view variance term을 빠뜨림.
모든 global embedding이 일치하는 등의 추가 조건이 없으면 Appendix B.6의 관련 등호도 그대로 증명되지 않음.
위 본문은 원문을 보존한 번역이며, 실제 코드가 계산하는 center-based loss와 원문의 pairwise loss가 완전히 동일하다고 단정하지 않음.
LeJEPA Loss.
- 최종 total loss는 위 prediction loss와 각 view의 SIGReg를 단순히 결합한 다음 식임.
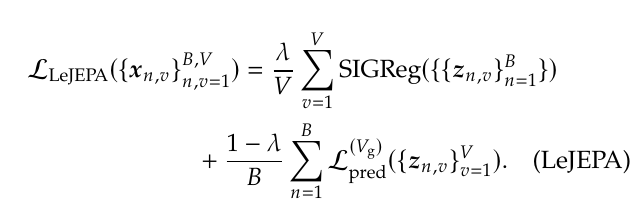
- Equation LeJEPA의 구현을 위 코드에 제시함.
- 통상적인 model definition·optimizer·data loader를 제외하면 전체 구현은 Algorithms 1·2의 PyTorch code처럼 수십 줄이면 충분함.
- Prototype·stop-gradient·teacher–student network가 없으므로, prediction term과 isotropic Gaussian term 사이 trade-off를 조절하는 λ 하나만 hyperparameter로 갖는 Equation LeJEPA가 매력적임.
5.2 Relation to Prior Work
- Section 6의 실험에 앞서, 제안한 LeJEPA·SIGReg objective가 기존 framework와 어떤 관계인지 논의함.
- JEPA에서 이런 slicing·distribution matching을 쓰는 기존 해법은 없지만 generative model·optimal transport에는 비슷한 pipeline이 존재함.
- 특히 Sliced Score Matching(Song et al., 2020)은 공간의 univariate slicing으로 generative model의 density estimation을 쉽게 하도록 제안함.
- 유사하게 sliced Wasserstein distance(Bonneel et al., 2015; Nguyen and Ho, 2023)는 이 전략으로 optimal transport를 빠르게 하고 개선함.
- 또한 Epps–Pulley integral을 본 연구의 quadrature 대신 정확히 계산하면, 각 slice loss는 두 분포 사이 distance를 측정하는 kernel MMD(Sriperumbudur et al., 2010; Gretton et al., 2012; Chwialkowski et al., 2016)와 같아지지만 complexity는 quadratic임.
- 마지막으로 선호하는 Epps–Pulley 대신 특정 test를 사용하는 LeJEPA의 극한에서 기존 SSL framework 일부를 복원할 수 있음.
- 예를 들어 T({xn}n=1B)=mean({xn}n=1B)2+(std({xn}n=1B)−1)2를 설정하여 SIGReg에 사용하면 slice 수가 커지는 극한에서 VICReg SSL method가 복원됨.
- 실제로 SIGReg는 expectation에서 𝔼[Z]=0, Cov(Z)=Id를 강제하며, Id는 d×d identity matrix임(Section B.14의 유도).
- Invariance term도 view embedding 사이 ℓ2 distance이므로, 이 degenerate statistical test에서 LeJEPA는 VICReg를 복원함.
- 그러나 Theorem 3에 따라 이런 설정은 VICReg에서도 이미 관찰된 shortcut solution을 만들므로 강하게 권장하지 않음.
6 LeJEPA: Empirical Validation
- Section 5.1의 LeJEPA 구현으로 포괄적인 실험을 수행하여 효과를 보임.
- LeJEPA가 (i) 여러 architecture·dataset에서 안정적으로 학습되고(Section 6.1), (ii) model selection에 유용한 training loss를 제공하며(Section 6.2), (iii) 작은 규모의 in-domain pretraining에서 최첨단 vision model보다 높고(Section 6.3), (iv) ImageNet-1K에서 약 10억 parameter까지 성공적으로 확장되며(Section 6.4), (v) 명시적인 supervision 없이 풍부한 semantic segmentation feature를 학습함을 보임.
6.1 LeJEPA’s Stability Across Hyper-Parameters and Architectures
- Hyperparameter·architecture·experimental setup 전반에서 LeJEPA의 안정성을 보임.
- 추가적인 cross-domain stability 결과는 Section 6.3에 있음.
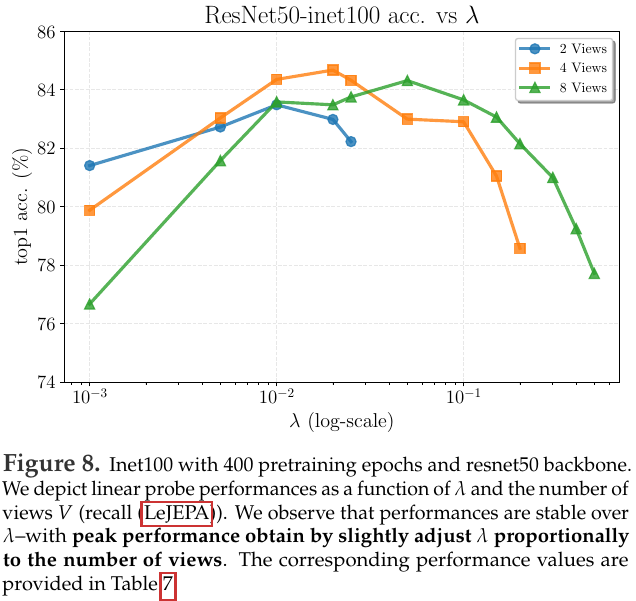
- Figure 8. ImageNet-100에서 ResNet-50 backbone을 400 epoch pretraining한 결과임.
- Linear probe 성능을 λ와 view 수 V의 함수로 나타냄(Equation LeJEPA 참조).
- λ 전반에 걸쳐 성능이 안정적이며, view 수에 비례하여 λ를 조금 조정하면 peak 성능을 얻음.
- 대응 성능 값은 Table 7에 있음.
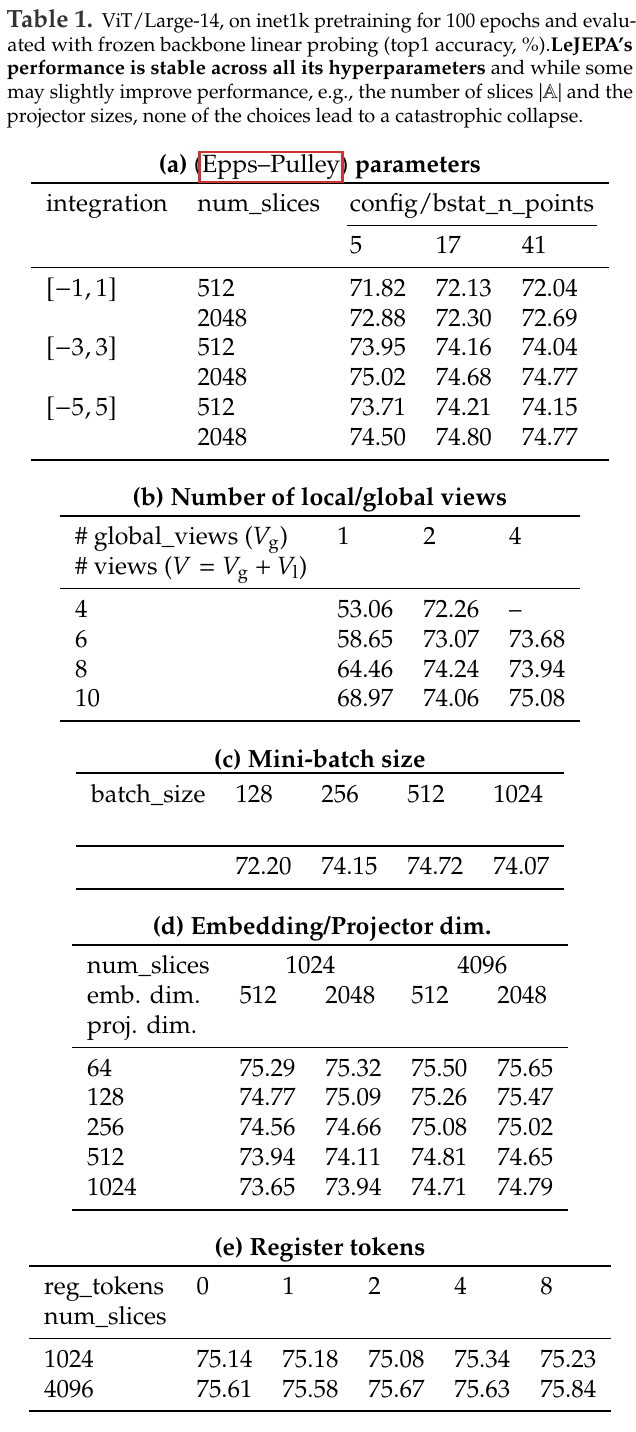
- Table 1. ImageNet-1K에서 ViT-Large/14를 100 epoch pretraining하고 frozen-backbone linear probing으로 평가한 top-1 accuracy(%)임.
- LeJEPA는 모든 hyperparameter에서 안정적이며, slice 수 |𝔸|·projector 크기 같은 일부 선택은 조금 개선되지만 어떤 선택도 catastrophic collapse를 일으키지 않음.
- (a) Epps–Pulley parameter임.
- (b) Local/global view 수임.
- (c) Minibatch 크기임.
- (d) Embedding/projector dimension임.
- (e) Register token임.
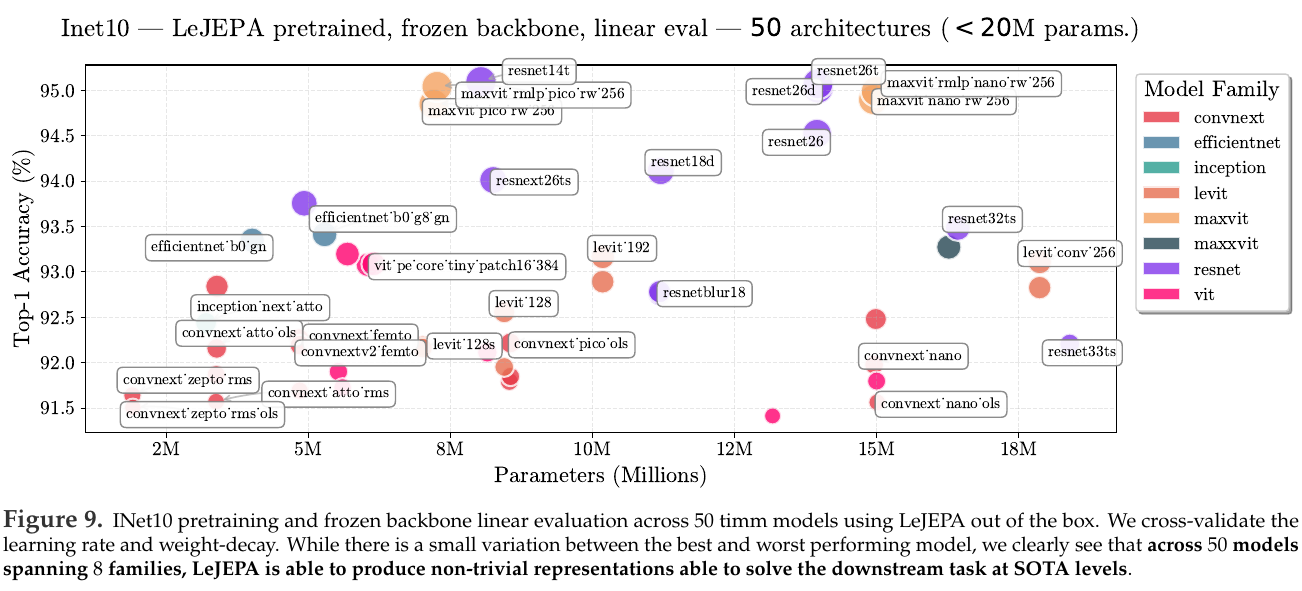
- Figure 9. ImageNet-10에서 50개 timm model에 LeJEPA를 바로 적용하여 pretraining하고 frozen-backbone linear evaluation을 수행함.
- Learning rate·weight decay를 cross-validation함.
- 최고·최저 model 사이 작은 차이는 있지만, 8개 family의 50개 model 모두 downstream task를 SOTA 수준으로 해결하는 non-trivial representation을 생성할 수 있음을 명확히 보임.
- 일반 hyperparameter 전반의 안정성임.
- 먼저 ImageNet-100·ImageNet-1K에서 LeJEPA를 평가함.
- ImageNet-100에서는 ResNet-50을 학습하며 view 수와 loss weight λ를 바꿈(Figure 8).
- 양쪽 축 모두에서 성능이 안정적이므로 robust default로 λ=0.05를 권장함.
- ImageNet-1K에서는 ViT-Large/14를 학습하며 batch size와 global view 수 Vg·local view 수 Vl를 탐색함(Table 1b).
- 기존 연구의 통상적 구성인 Vg=2,Vl=8이 LeJEPA에도 잘 적용됨.
- 특히 ImageNet-1K에서 batch size 128처럼 작아도 경쟁력 있는 성능을 내므로(Table 1c), 기존 방법보다 memory 요구량이 낮을 수 있음.
- 따라서 시작점으로 λ=0.05, Vg=2, Vl=8, batch size ≥128을 권장함.
‘Hyperparameter 하나’와 optimizer 설정은 모순인가?
핵심 loss에서 두 목적을 섞는 trade-off parameter가 λ 하나라는 뜻으로 읽어야 함.
Learning rate·weight decay·view 구성·batch size·direction 수·integration grid 같은 구현과 training 설정은 여전히 존재함.
논문은 이 설정에 대한 안정성을 실험하고 robust starting point를 권장함.
예를 들어 slice 수가 충분하지 않으면 통계적 coverage와 computation의 trade-off가 생기므로, 단일 loss weight라는 표현을 모든 tuning이 사라진다는 뜻으로 확대하지 않음.
- Epps–Pulley hyperparameter 전반의 안정성임.
- SIGReg slice 수 |𝒜|, Epps–Pulley integration domain, numerical integration quadrature point 수 등 LeJEPA 특유의 hyperparameter를 검토함.
- Table 1a는 ImageNet-1K·ViT-Large/14의 ablation임.
- Integration domain과 quadrature point 수가 성능에 미치는 영향은 무시할 수준임.
- Characteristic function이 0에서 정확하므로 작은 integration range로도 분포의 moment가 잘 규명된다는 점에서 예상되는 결과임.
- Slice 수는 적당한 영향을 주며, 더 많으면 조금 좋아지지만 512개만으로도 경쟁력 있음.
- 따라서 시작점으로 integration point 17개, integration domain [−5,5], slice 1024개를 권장함.
- Architecture 전반의 안정성임.
- I-JEPA·DINOv2 같은 최근 방법과 비교한 주요 장점은 architecture-agnostic 설계임.
- 현대 self-supervised method 대부분이 Vision Transformer에 맞춰져 있지만, LeJEPA는 수정 없이 여러 architecture family에서 작동함.
- 검증을 위해 timm library에서 20M 미만 parameter의 model을 모두 선택하여, 8개 family의 약 50개 architecture를 ImageNet-10에서 pretraining함.
- 모든 model이 고품질 representation을 학습하여 frozen-backbone linear probing의 top-1 accuracy 91.5~95%에 도달함.
- ResNet·ViT처럼 supervised learning에서 잘하는 model이 LeJEPA에서도 선호할 model인 것으로 보임.
- 따라서 EfficientNet 같은 특화 model보다 ResNet·ViT 같은 표준 architecture에서 시작할 것을 권장함.
- 널리 쓰이는 heuristic의 제거임.
- Model·dataset 전반의 안정적 성능 외에도 LeJEPA의 증명 가능한 구성은 기존 collapse 방지 heuristic을 많이 없애게 함.
- 첫째, 기존 실험·이론 연구에서 비대칭 정보가 없는 image JEPA의 predictor와 teacher–student architecture는 주로 collapse 방지에 쓰임이 밝혀졌음(Grill et al., 2020; Jing et al., 2021; Tian et al., 2021; Caron et al., 2021; Chen et al., 2021).
- 이 구성 요소를 없애면 encoder가 collapse하여 chance-level 성능을 냄.
- LeJEPA는 SIGReg loss 덕분에 predictor·teacher–student architecture 모두를 없애도 collapse하지 않음(Table 4).
- Teacher–student 구성이 ViT에서 작은 성능 향상을 주기는 하지만, 이는 supervised learning의 Stochastic Weight Averaging(SWA) 관찰과 일치하며(Izmailov et al., 2019), collapse 방지에 필수는 아님.
- 본 설정에서는 Equation 6의 μ를 생성하는 encoder에 SWA를 적용함.
- 둘째, 최근 연구는 vision model의 training instability를 막으려면 register token이 필요하다고 보였음(Oquab et al., 2023; Siméoni et al., 2025; Darcet et al., 2023).
- Table 1은 이런 instability가 poorly conditioned training objective에서 비롯될 가능성을 보임.
- 반면 LeJEPA는 register token이 필요 없고, 있거나 없거나 안정적인 성능을 냄.
- 따라서 predictor·register token 없이 학습하고, ViT에서는 선택적으로 SWA를 적용해 성능 향상을 얻는 것을 권장함.
- Experiment Details 1임.
- 단순성을 위해 통일된 pretraining pipeline을 채택함.
- 대응 caption에서 달리 밝히지 않는 한, Section 6.1에서 나온 다음 parameter를 모든 실험·그림에 적용함.
- LeJEPA 구현은 Algorithm 2에 제시하며 hyperparameter는 λ임.
- 모든 backbone은 timm에서, 모든 optimizer·scheduler는 PyTorch에서 수정 없이 사용함.
- 8개 view(V=8)를 사용하며, 이 중 global view는 2개(Vg=2)임.
- 해상도는 global view 224×224, local view 96×96임.
총 view 8개와 global 2개·local 8개는 같은 설정인가?
같은 설정이 아님.
Section 6.1의 권장 시작점은 global 2개와 local 8개이므로 총 10개 view이며, Experiment Details 1은 총 8개 중 global 2개를 사용한다고 명시함.
후자의 정의대로라면 local view는 6개가 됨.
본문의 권장 구성과 구체적 실험 공통 설정을 합쳐 하나의 숫자로 바꾸지 않고 각각 원문대로 보존하여 번역했으므로, 재현할 때 해당 실험의 caption·공식 설정을 확인해야 함.
- AdamW optimizer의 lr∈{5×10−3,5×10−4}, wd∈{10−1,10−2,10−5}를 사용함.
- Weight decay에는 scheduler가 없고, learning rate에는 표준 linear warm-up·cosine annealing을 적용함.
Abstract의 ‘scheduler 없음’과 learning-rate scheduler는 어떻게 구별하는가?
원문 abstract는 no hyperparameter schedulers라고 표현하지만 Experiment Details 1은 learning rate에 linear warm-up·cosine annealing을 사용한다고 명시함.
따라서 실제 구현을 이해할 때는 구체적인 실험 설정을 우선 확인해야 함.
Teacher EMA 같은 별도 heuristic schedule의 제거와 optimizer learning-rate schedule의 사용은 구별할 수 있지만, abstract의 넓은 표현 자체를 모든 scheduler의 부재로 해석하면 원문 세부 설정과 맞지 않음.
이 포스트는 둘 다 생략 없이 번역하고 차이를 보충 설명으로 남김.
6.2 LeJEPA’s Training Loss is Informative of Downstream Performance
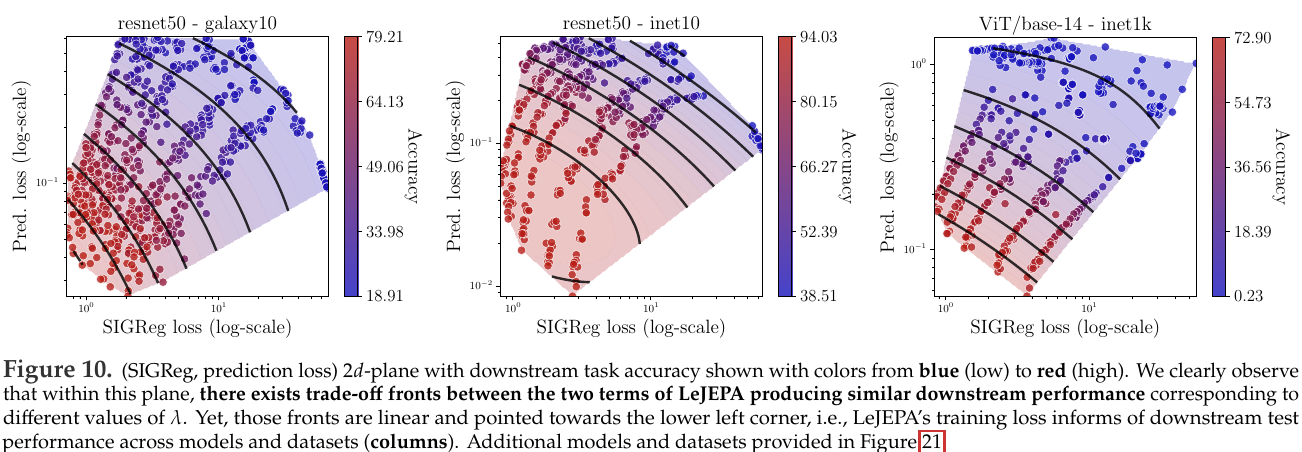
- Figure 10. SIGReg·prediction loss의 2D plane에서 downstream task accuracy를 낮은 값의 파란색부터 높은 값의 빨간색까지 표시함.
- 서로 다른 λ 값에 대응하며 유사한 downstream 성능을 내는 두 term 사이 trade-off front가 존재함.
- 그 front는 linear하고 왼쪽 아래를 향하므로, LeJEPA training loss가 model·dataset 전반의 downstream test 성능에 정보를 제공함(각 열).
- 추가 model·dataset은 Figure 21에 있음.
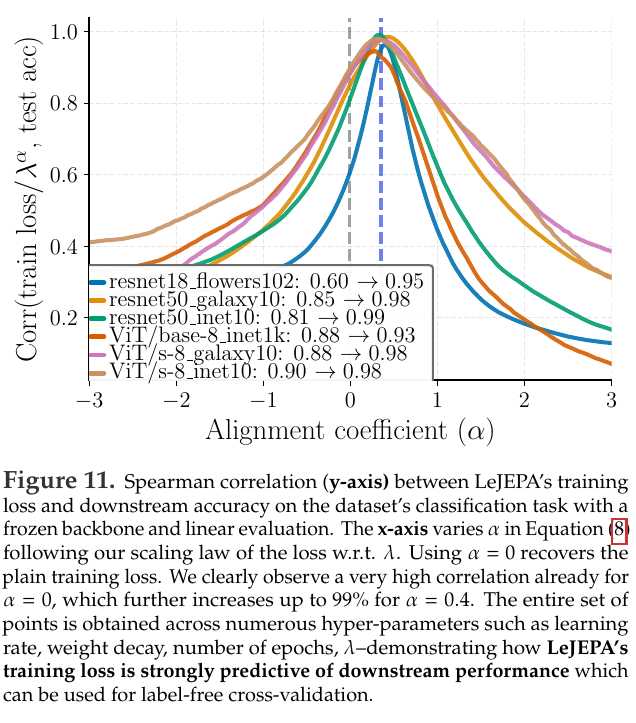
- Figure 11. LeJEPA training loss와 frozen-backbone linear evaluation으로 평가한 dataset classification accuracy 사이 Spearman correlation(y축)임.
- X축은 λ에 대한 loss scaling law를 따라 Equation 8의 α를 변화시킴.
- α=0이면 원래 training loss가 됨.
- α=0에서도 이미 correlation이 매우 높고, α=0.4이면 최대 99%까지 증가함.
- 전체 point는 learning rate·weight decay·epoch 수·λ 등 여러 hyperparameter에서 얻었으므로, LeJEPA training loss가 downstream 성능을 강하게 예측하며 label-free cross-validation에 쓰일 수 있음을 보임.
- SSL pretraining의 주요 과제는 learned representation의 quality를 알려주는 신뢰할 신호가 없다는 점임.
- 따라서 흔히 supervised downstream task 성능을 모니터링하고, 때로는 unsupervised embedding statistic을 보충함(Agrawal et al., 2022; Garrido et al., 2023; Thilak et al., 2023).
- 이 과정은 비싸고 지나치게 특화된 labeled data를 요구하므로 제약이 큼.
- 최근 JEPA model에서는 training loss와 downstream 성능의 correlation이 낮고, 학습 중 loss가 단조 감소하지도 않을 수 있어 문제가 더 심해짐.
- 반면 LeJEPA의 training loss는 훨씬 유리하게 작동하여 model quality에 대한 의미 있는 신호를 제공함.
- 먼저 Figure 10의 SIGReg·prediction loss로 이뤄진 2D plane에서 downstream accuracy와 명확한 경향을 볼 수 있음.
- 더 놀랍게도 mixing coefficient λ를 사용하는 combined training loss(Equation LeJEPA)는 downstream accuracy와 약 85%라는 높은 Spearman correlation ρs를 보이며(Spearman, 1961), 이는 강한 신호로 간주됨.
- 이 관계는 dataset·architecture 전반에서 성립함.
- 따라서 더 낮은 LeJEPA training loss는 더 높은 downstream 성능을 신뢰성 있게 나타냄.
Spearman correlation 99%는 accuracy 99%라는 뜻인가?
Spearman correlation은 두 변수의 순위가 얼마나 일관되게 함께 변하는지 나타내는 값임.
설명용으로 여러 model의 training loss 순위가 downstream 성능 순위와 잘 대응하면 model selection에 유용함.
이는 downstream classification accuracy 자체가 99%라는 뜻이 아니고, 한 sample의 label을 99% 확률로 맞힌다는 뜻도 아님.
논문은 여러 hyperparameter run의 순위를 비교하여 label-free cross-validation의 가능성을 보인 것임.
- Trade-off weight λ에 근거한 단순한 다음 scaling law로 correlation을 더 높일 수 있음.
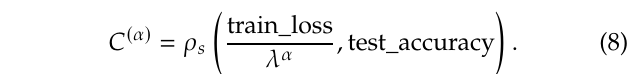
- α≈0.4로 설정하면 여러 dataset·model 전반에서 LeJEPA training loss와 downstream 성능 사이 거의 99%의 correlation을 얻음.
- Figure 11에는 여러 dataset·model에서 α에 따른 C(α) 변화를, Figure 19에는 LeJEPA training loss와 downstream 성능을 제시함.
- Training loss와 model quality의 강한 정렬은 label-free SSL model selection·cross-validation을 가능하게 함.
6.3 In-Domain LeJEPA Outperforms Frontier Model Transfer Learning
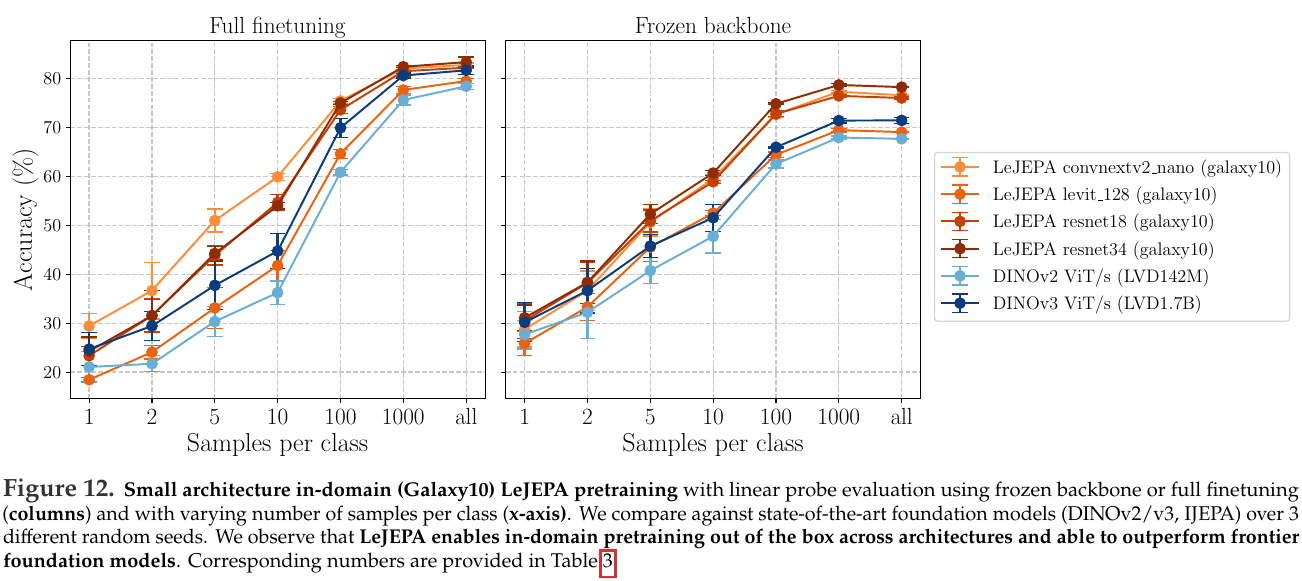
- Figure 12. 작은 architecture를 Galaxy10에서 in-domain LeJEPA pretraining한 뒤, frozen-backbone linear probe 또는 full finetuning(각 열)으로 평가하고 class당 sample 수(x축)를 바꾼 결과임.
- 세 random seed에서 최첨단 foundation model인 DINOv2/v3·I-JEPA와 비교함.
- LeJEPA는 architecture 전반에서 바로 in-domain pretraining을 가능하게 하며 최첨단 foundation model을 능가할 수 있음.
- 대응 수치는 Table 3에 있음.
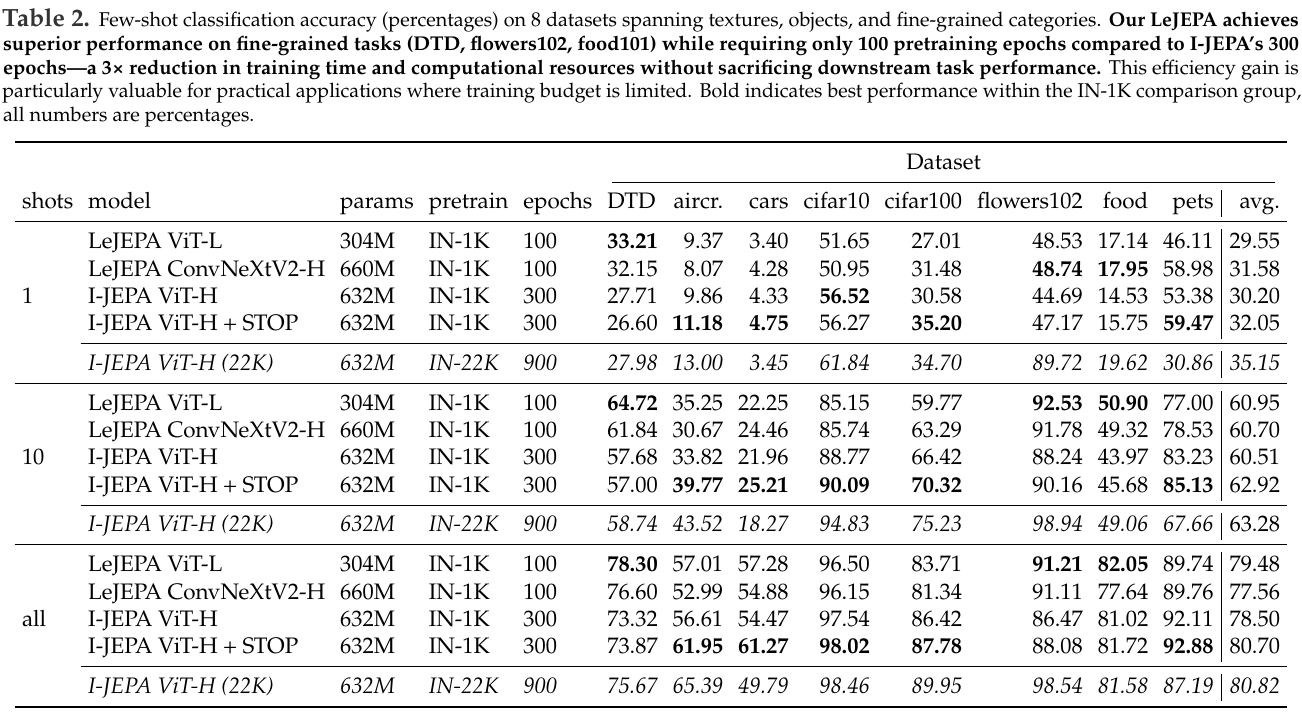
- Table 2. Texture·object·fine-grained category를 포함하는 8개 dataset의 few-shot classification accuracy(%)임.
- LeJEPA는 I-JEPA의 300 epoch 대비 100 epoch pretraining만으로 DTD·Flowers102·Food101의 fine-grained task에서 더 높은 성능을 냄.
- 즉 downstream 성능을 희생하지 않고 training time·computational resource를 3분의 1로 줄임.
- 이 효율 향상은 training budget이 제한된 실제 응용에서 특히 유용함.
- Bold는 IN-1K 비교 집단 내 최고 성능을 뜻하며, 모든 수치는 percentage임.
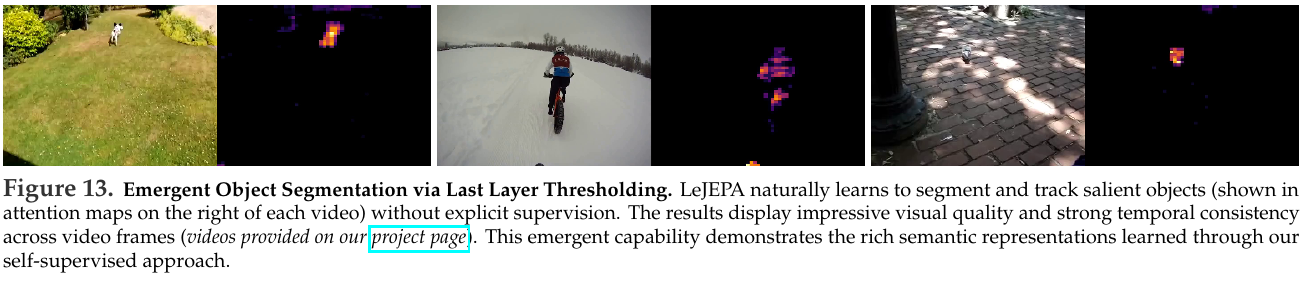
- Figure 13. Last-layer thresholding에서 emergent object segmentation이 나타남.
- LeJEPA는 명시적 supervision 없이 salient object를 segment·track하는 능력을 자연스럽게 학습하며, 각 video 오른쪽의 attention map에 표시함.
- 결과는 인상적인 visual quality와 video frame 사이 강한 temporal consistency를 보임(project page에 video 제공).
- 이 emergent capability는 self-supervised 접근이 학습한 풍부한 semantic representation을 보여줌.
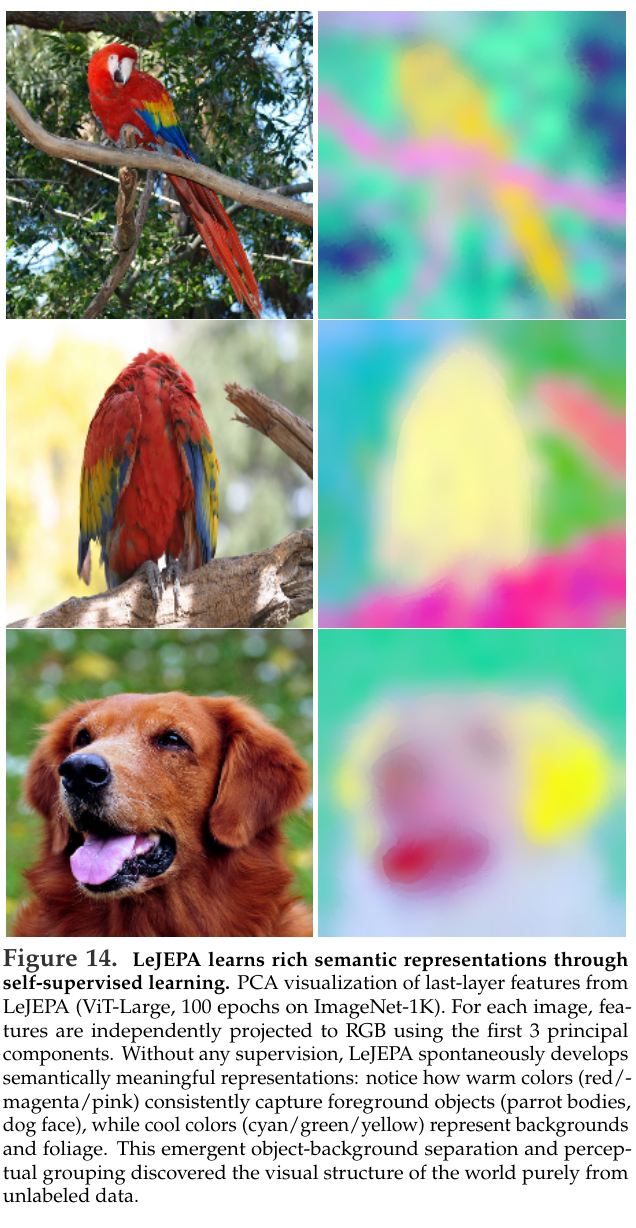
- Figure 14. LeJEPA는 self-supervised learning으로 풍부한 semantic representation을 학습함.
- ImageNet-1K에서 100 epoch 학습한 ViT-Large의 last-layer feature를 PCA로 시각화함.
- 각 image의 feature를 독립적으로 처음 세 principal component를 사용하여 RGB에 projection함.
- Supervision 없이도 의미 있는 representation을 자발적으로 형성하며, 따뜻한 색인 red·magenta·pink가 foreground object인 앵무새의 몸·개의 얼굴을 일관되게 포착하고, 차가운 색인 cyan·green·yellow가 background·foliage를 나타냄을 볼 수 있음.
- 이 emergent object–background separation과 perceptual grouping은 unlabeled data만으로 세계의 visual structure를 발견했음을 보임.
- Self-supervised learning의 중요한 약속은 task·domain 전반에 generalize하는 universal representation의 학습임.
- 하지만 DINOv2/v3·I-JEPA 같은 현재 최첨단 foundation model은 natural image로 pretraining되어, 특수 domain의 실무자는 supervised finetuning을 위해 많은 label을 수집해야 함.
- 실제로 대부분의 최첨단 model은 해당 domain의 sample 수가 작을 수 있고 hyperparameter를 다시 탐색하는 일이 번거롭지만 필요하므로, 그 domain에서 직접 학습할 수 없음(Assran et al., 2022).
- LeJEPA의 versatility와 이 문제를 해결하는 능력을 보이기 위해 loss·pretraining pipeline을 전혀 바꾸지 않고 새 domain에서 직접 pretraining함.
- Visual structure·statistical property가 natural image와 상당히 다른 galaxy morphology classification task인 Galaxy10을 선택함(Balestriero et al., 2025).
- Dataset은 galaxy type 10개에 걸친 training sample 11,000개를 포함함.
- LeJEPA에는 default hyperparameter를 사용하고 여러 backbone을 400 epoch pretraining함.
- 최신 DINOv2·DINOv3·I-JEPA와 비교함.
- Figure 12에 frozen-backbone linear probing과 full finetuning의 top-1 accuracy를 보고함.
- LeJEPA의 in-domain pretraining은 linear probing·full finetuning 모두에서 최첨단 model인 DINOv2·DINOv3를 크게 능가함.
- Table 5의 추가 dataset·backbone 결과는 Flowers102처럼 sample이 1000개인 dataset에서도 in-domain 학습이 가능함을 보임.
- 이 결과와 architecture·hyperparameter 전반의 안정성을 함께 고려하면 최신 최첨단 model이 아직 다루지 않는 domain에 유망한 대안을 제공할 것임.
In-domain pretraining과 transfer learning 비교에서 무엇을 봐야 하는가?
In-domain pretraining은 target domain의 unlabeled data로 encoder부터 학습하는 것이고, transfer learning은 다른 domain에서 pretrained model을 가져오는 것임.
Galaxy image는 natural image와 통계·구조가 다르므로 generic feature가 최선이 아닐 수 있음.
Frozen backbone의 linear probe와 전체 parameter를 바꾸는 full finetuning은 적응 자유도가 다르므로 별도로 비교해야 함.
또한 서로 다른 backbone 크기·pretraining data·epoch를 같은 조건으로 혼동하지 않도록 Table 2·5와 Figure 12의 setting을 함께 확인함.
6.4 LeJEPA Scales Across Data and Models
- 더 큰 pretraining dataset인 ImageNet-1K와 ViT-Large(0.3B)·ConvNeXtV2-Huge(0.6B) 같은 큰 backbone에 LeJEPA를 적용함.
- 두 model의 ImageNet-1K online linear probe accuracy는 각각 77.1%, 78.5%임.
- In-distribution 성능 외에 transfer learning도 탐구함.
- 가장 가까운 설정인 ViT-Huge(0.6B) I-JEPA를 baseline으로 하고, stochastic prediction task를 추가한 최근 개선형 I-JEPA + STOP(Bar et al., 2023)도 포함함.
- LeJEPA는 Section 6.1과 같은 recipe를 사용하고 frozen-backbone transfer learning 성능을 Table 2에 보고함.
- 더 작은 model과 더 짧은 training schedule을 사용하면서도 I-JEPA보다 일관되게 높음.
- Top-1 accuracy 외에 Section 6.2에서 확인한 training loss quality도 재확인함.
- 본 설정의 training curve는 매우 안정적이고 smooth하여, 세심한 hyperparameter 선택이 필요 없는 stable optimization landscape를 시사함(Section 4.2.3 참조).
- 1.8B parameter의 ViT-gigantic 예를 Figure 1에 제시함.
6.5 Emergent Semantic Structure in LeJEPA Representations
- 명시적 supervision 없이 의미 있는 attention pattern이 나타나는 것은 성공적인 self-supervised learning의 특징임(Caron et al., 2021).
- LeJEPA가 이런 구조를 학습하는지 평가하기 위해 learned representation의 attention map을 시각화함.
- DINO(Caron et al., 2021)를 따라 embedding에 PCA를 적용하고 첫 principal component들을 시각화하면 object boundary·salient region과 명확한 대응이 나타남(Figure 14).
- 또한 temporal consistency·object understanding이 필요한 어려운 task인 unsupervised video segmentation에 attention pattern을 쓸 수 있는지 탐구함.
- [CLS] token의 self-attention map을 thresholding하여, 학습 중 segmentation label 없이 frame을 가로질러 object를 추적하는 binary mask를 얻음.
- Figure 13처럼 attention은 remarkable temporal coherence를 유지하며 foreground object와 background를 자연스럽게 segment하므로, representation이 spatial semantics와 temporal structure 모두를 포착함을 시사함.
- 이 emergent capability는 안정성에 집중한 objective가 learned feature의 semantic richness를 희생하지 않음을 보여줌.
7 Conclusion
- JEPA 기반 self-supervised learning의 핵심 병리 현상을 근본적으로 해결하는 원칙적인 theoretical framework를 확립했음.
- 이론·실용을 아우르는 기여로, isotropic Gaussian embedding이 worst-case downstream risk를 유일하게 최소화함을 증명하고, 이 분포를 강제하는 tractable하고 정확성이 증명된 SIGReg를 제안했으며, teacher–student network·stop-gradient·비대칭 architecture의 ad-hoc 조합이 아니라 설계 자체로 representation collapse를 없앰을 보였음.
- Domain 전반과 1.8B parameter의 거대 버전을 포함한 60개 이상 architecture에서 LeJEPA를 검증함.
- 단순함에도 core 구현 50줄 미만으로 최첨단 성능과 대등함.
- 특히 SSL이 오랫동안 필요로 한, 실용적인 algorithm design에 직접 지침을 주는 수학적으로 엄밀한 기초를 제공함.
Acknowledgments
- 원고에 귀중한 feedback을 제공한 Mike Rabbat·Lucas Maes에게 감사를 전함.